Cinemática inversa de manipuladores seriales
BE3027 - Robótica Médica
¿Qué tenemos hasta ahora?
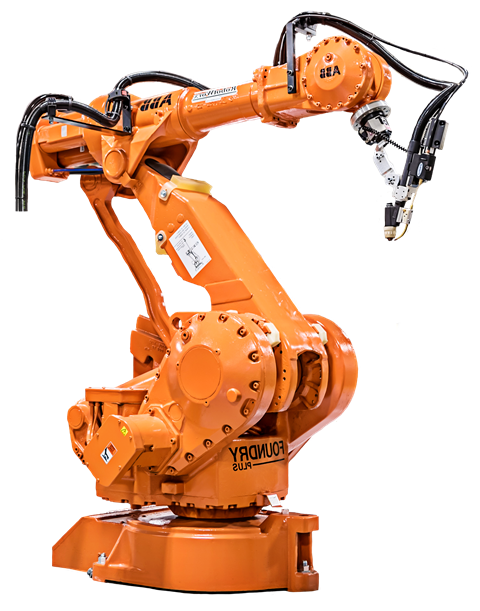
\mathbf{q}
\mathcal{K}\left(\mathbf{q}\right) \subseteq {^B}\mathbf{T}_E(\mathbf{q})
\mathcal{K}:\mathcal{C}\to \mathcal{T}
cinemática directa
\dot{\mathbf{q}}
{^B}\mathcal{V}_E=\begin{bmatrix} {^B}\mathbf{v}_E \\ {^B}\boldsymbol{\omega}_{BE} \end{bmatrix}
{^B}\mathcal{V}_E=\mathbf{J}(\mathbf{q})\dot{\mathbf{q}}
cinemática diferencial
\dot{\mathbf{q}}
{^B}\mathcal{V}_E=\begin{bmatrix} {^B}\mathbf{v}_E \\ {^B}\boldsymbol{\omega}_{BE} \end{bmatrix}
{^B}\mathcal{V}_E=\mathbf{J}(\mathbf{q})\dot{\mathbf{q}}
cinemática diferencial
¿A qué queremos llegar?
\mathbf{q}
\subseteq {^B}\mathbf{T}_E(\mathbf{q})
\mathcal{K}^{-1}:\mathcal{T}\to \mathcal{C}
cinemática inversa
especificación de la tarea
(se tiene)
referencias para los servos
(se quiere)
A pesar que el planteamiento es claro, se tiene un problema considerable
\mathcal{K}^{-1}\left( \mathcal{K}(\mathbf{q})\right)=\mathbf{q}
A pesar que el planteamiento es claro, se tiene un problema considerable
\mathcal{K}^{-1}\left( \mathcal{K}(\mathbf{q})\right)=\mathbf{q}
\mathcal{K}(\mathbf{q})
(en general) función extremadamente no lineal de la configuración
A pesar que el planteamiento es claro, se tiene un problema considerable
\mathcal{K}^{-1}\left( \mathcal{K}(\mathbf{q})\right)=\mathbf{q}
\mathcal{K}^{-1}
encontrar este mapeo resulta muy difícil y en muchos casos NO existe solución analítica
Ejemplo: cinemática inversa analítica
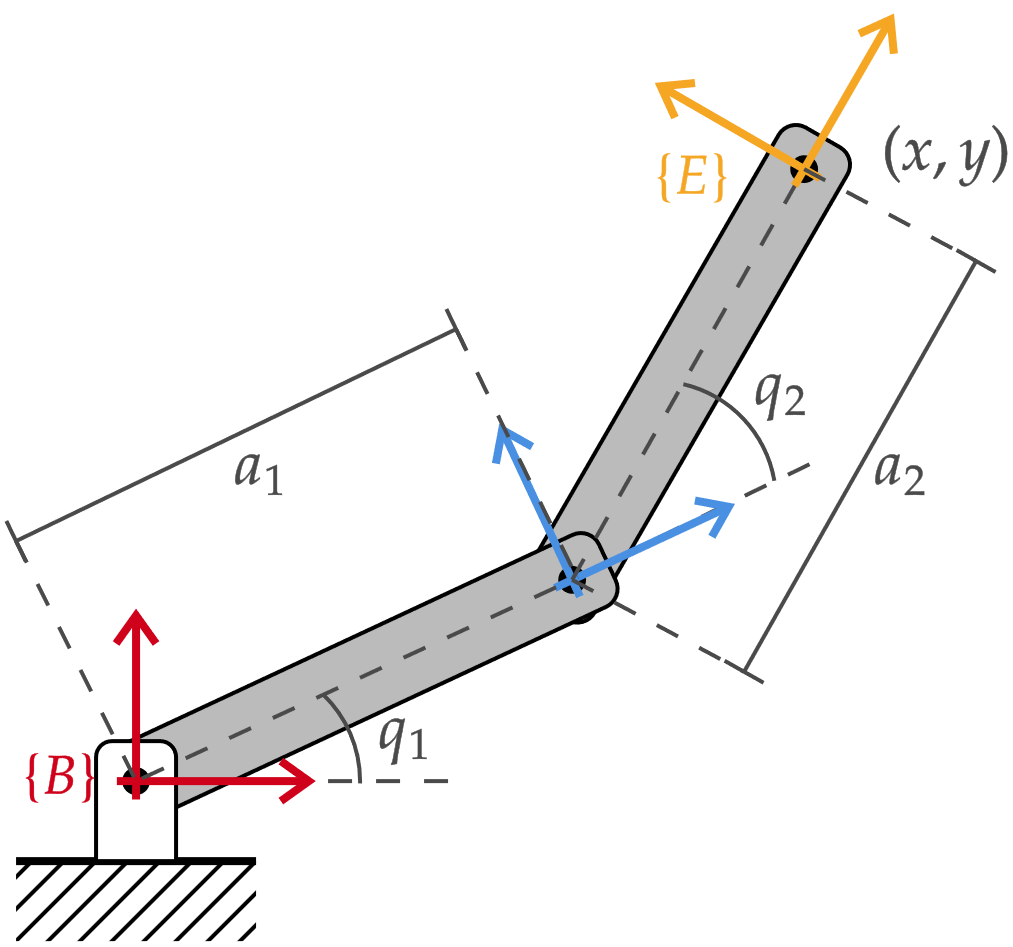
\mathbf{q}=\begin{bmatrix} q_1 \\ q_2 \end{bmatrix} \in \mathbb{R}^2
\mathcal{T} \sim (x,y) \subset SE(2)
espacio de configuración
espacio de tarea
Ejemplo: cinemática inversa analítica
\begin{array}{c|c|c|c}
\theta_j & d_j & a_j & \alpha_j \\ \hline
q_1 & 0 & a_1 & 0 \\ \hline
q_2 & 0 & a_2 & 0 \\
\end{array}
R
R
manipulador RR
{^B}\mathbf{T}_E(\mathbf{q})=\begin{bmatrix} \cos(q_1+q_2) & -\sin(q_1+q_2) & 0 & a_2\cos(q_1+q_2)+a_1\cos(q_1) \\ \sin(q_1+q_2) & \cos(q_1+q_2) & 0 & a_2\sin(q_1+q_2)+a_1\sin(q_1) \\ 0 & 0 & 1 & 0 \\ 0 & 0 & 0 & 1 \end{bmatrix}
\mathbf{J}(\mathbf{q})=
\begin{bmatrix} -a_1\sin(q_1)-a_2\sin(q_1 + q_2) & -a_2\sin(q_1 + q_2) \\ a_1\cos(q_1)+a_2\cos(q_1 + q_2) & a_2\cos(q_1 + q_2) \\ 0 & 0 \\ 0 & 0 \\ 0 & 0 \\ 1 & 1 \end{bmatrix}
{^B}\mathbf{T}_E(\mathbf{q})=\begin{bmatrix} \cos(q_1+q_2) & -\sin(q_1+q_2) & 0 & a_2\cos(q_1+q_2)+a_1\cos(q_1) \\ \sin(q_1+q_2) & \cos(q_1+q_2) & 0 & a_2\sin(q_1+q_2)+a_1\sin(q_1) \\ 0 & 0 & 1 & 0 \\ 0 & 0 & 0 & 1 \end{bmatrix}
\mathcal{K}\left(\mathbf{q}\right)=
{^B}\begin{bmatrix} x_E(\mathbf{q}) \\ y_E(\mathbf{q}) \end{bmatrix}=
\begin{bmatrix} a_1\cos(q_1)+a_2\cos(q_1+q_2) \\ a_1\sin(q_1)+a_2\sin(q_1+q_2) \end{bmatrix}
\Rightarrow \mathbf{q}=
\mathcal{K}^{-1}\left({^B}\begin{bmatrix} x_E(\mathbf{q}) \\ y_E(\mathbf{q}) \end{bmatrix}\right)
empleando trigonometría y métodos algebráicos
q_1=\mathrm{atan2}\left(\dfrac{y_E}{x_E}\right)-\mathrm{atan2}\left(\dfrac{a_2\sin(q_2)}{a_1+a_2\cos(q_2)}\right)
q_2=\arccos\left( \dfrac{x_E^2+y_E^2-a_1^2-a_2^2}{2 a_1a_2}\right)
empleando trigonometría y métodos algebráicos
q_1=\mathrm{atan2}\left(\dfrac{y_E}{x_E}\right)-\mathrm{atan2}\left(\dfrac{a_2\sin(q_2)}{a_1+a_2\cos(q_2)}\right)
q_2=\arccos\left( \dfrac{x_E^2+y_E^2-a_1^2-a_2^2}{2 a_1a_2}\right)
\(\arctan\) pero válida en \((-\pi, \pi]\) (programación)
las expresiones trigonométricas muestran múltiples soluciones al problema
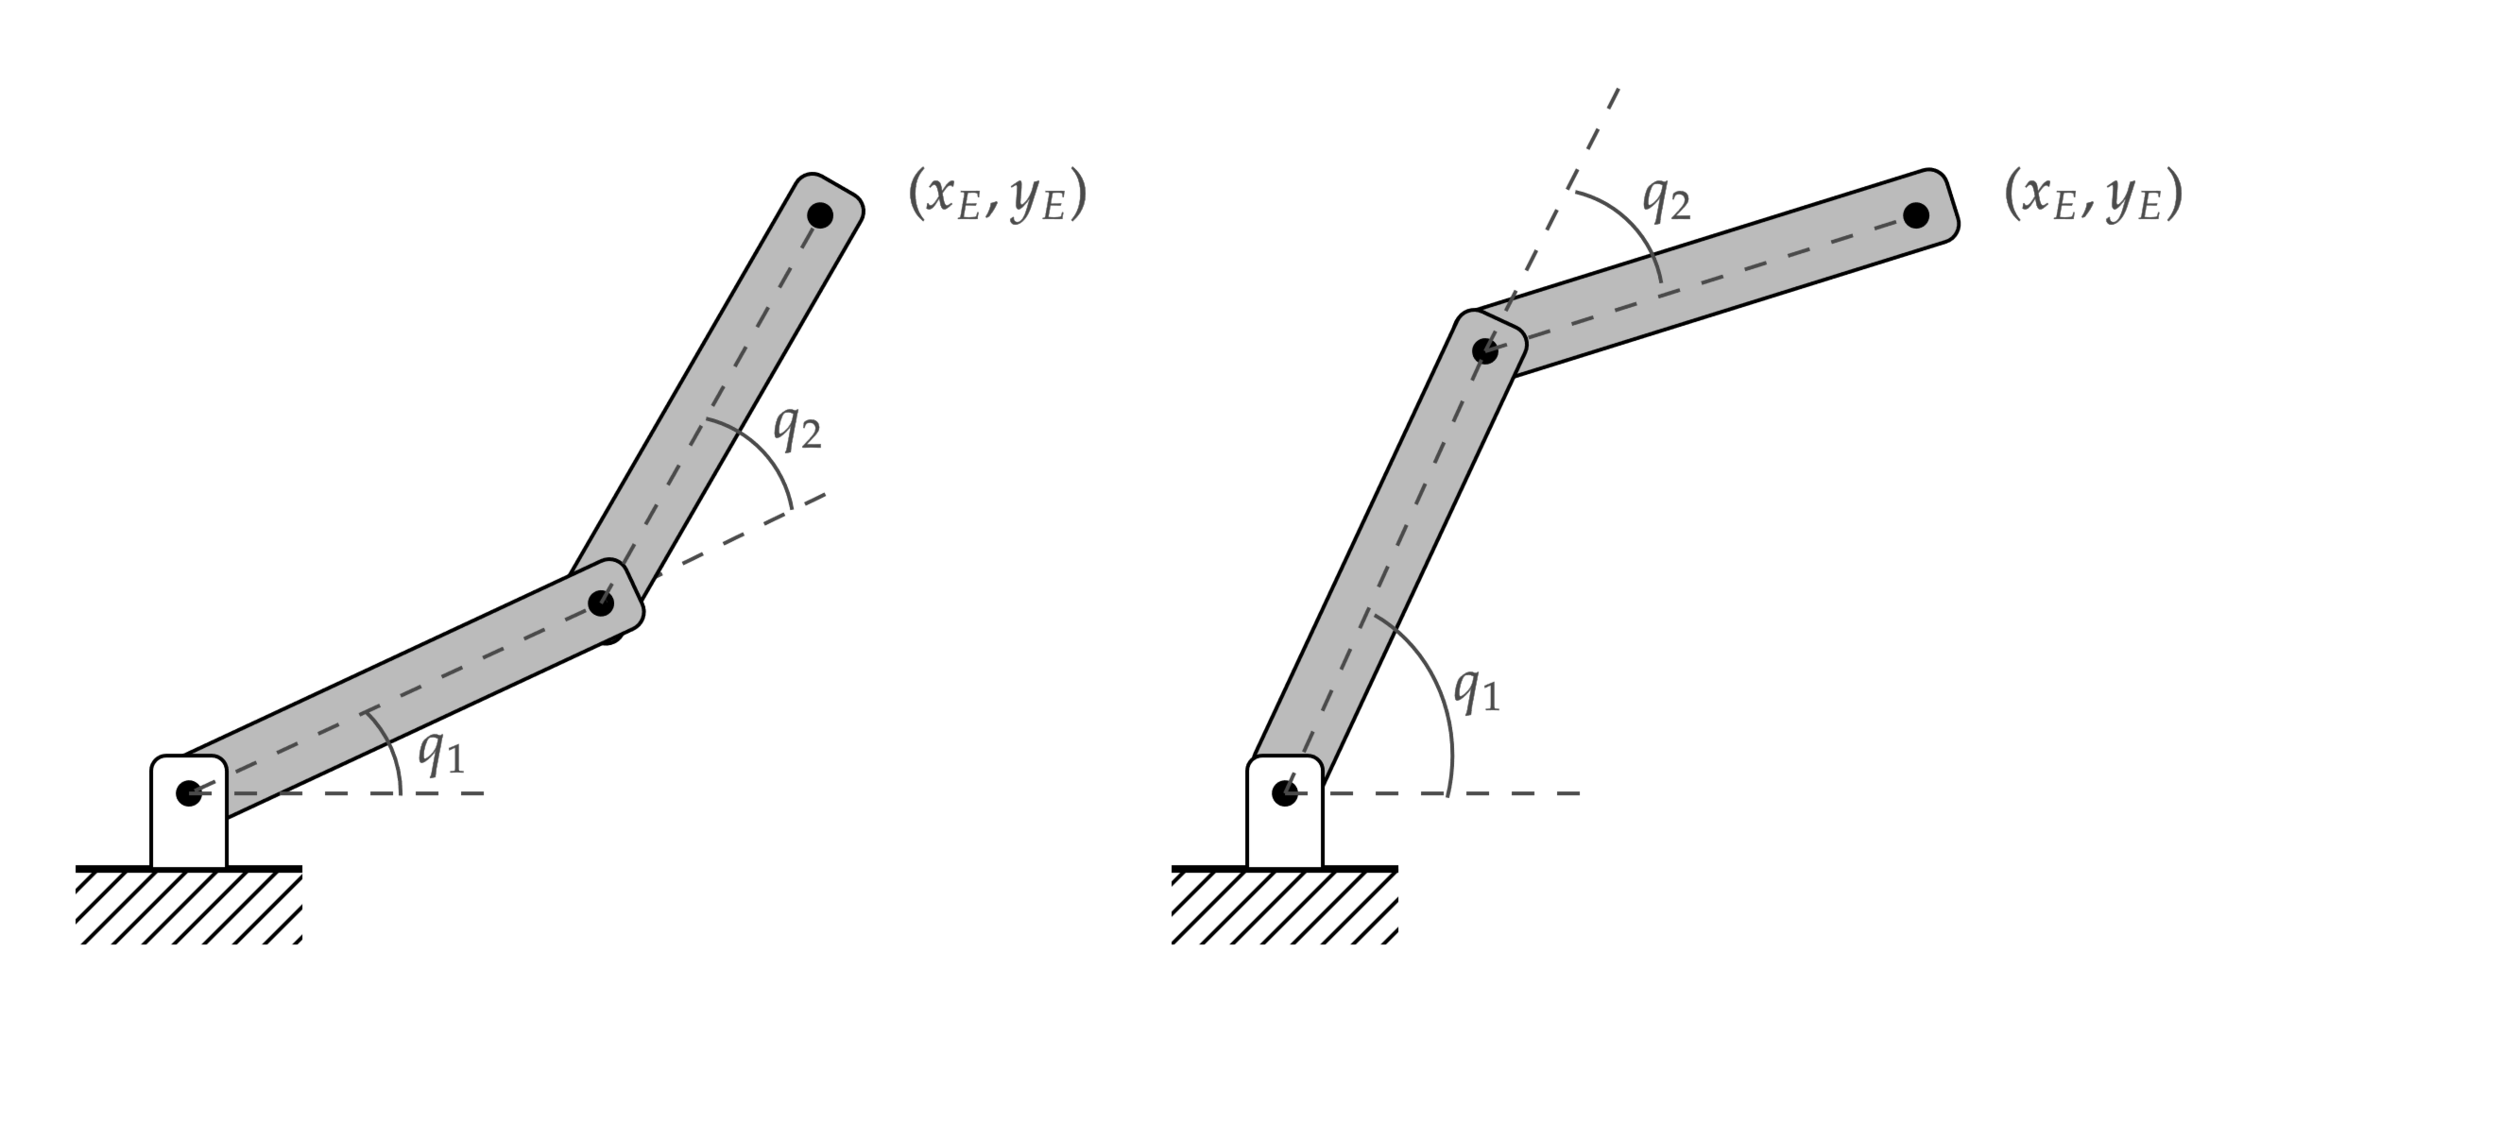
si bien hay casos en donde podemos encontrar la solución analítica, hacerlo no es tan buena idea
\(\to\) expresiones complejas e individuales, incluso para manipuladores triviales
\(\to\) solución dada en lazo abierto (no corrige errores)
¿Qué hacemos entonces?
emplear algoritmos basados en control (lazo cerrado) para encontrar la cinemática inversa de forma numérica
>> be3027_clase7_robotRR_ik.mlx
{}^{B}_{}\bm{\xi}_{E}(t)=\begin{bmatrix}
{}^{B}_{}\bm{o}_E(\mathbf{q}(t))\\
{}^{B}_{}\bm{\theta}_E(\mathbf{q}(t))
\end{bmatrix}
pose del efector final como vector de estado
{}^{B}_{}\dot{\bm{\xi}}_{E}=\begin{bmatrix}
{}^{B}_{}\bm{V}_E\\
{}^{B}_{}\bm{\omega}_{BE}
\end{bmatrix}
=\mathbf{J}(\mathbf{q})\dot{\mathbf{q}}
orientación del efector final en forma vectorial
\bm{e} = \begin{bmatrix}
\mathbf{e}_p \\
\mathbf{e}_o
\end{bmatrix}=
\bm{\xi}_{d}-{}^{B}_{}\bm{\xi}_{E}
\dot{\bm{e}} = \dot{\bm{\xi}}_{d}-{}^{B}_{}\dot{\bm{\xi}}_{E}=\dot{\bm{\xi}}_{d}-\mathbf{J}(\mathbf{q})\dot{\mathbf{q}}
\bm{e} = \begin{bmatrix}
\mathbf{e}_p \\
\mathbf{e}_o
\end{bmatrix}=
\bm{\xi}_{d}-{}^{B}_{}\bm{\xi}_{E}
\dot{\bm{e}} = \dot{\bm{\xi}}_{d}-{}^{B}_{}\dot{\bm{\xi}}_{E}=\dot{\bm{\xi}}_{d}-\mathbf{J}(\mathbf{q})\dot{\mathbf{q}}
error de pose
error de orientación
error de posición
pose de EF deseada
dinámica del error
\dot{\bm{e}} = \dot{\bm{\xi}}_{d}-{}^{B}_{}\dot{\bm{\xi}}_{E}=\dot{\bm{\xi}}_{d}-\mathbf{J}(\mathbf{q})\dot{\mathbf{q}}
Ley de control: imponemos una dinámica deseada para el error
\dot{\bm{e}} = \dot{\bm{\xi}}_{d}-{}^{B}_{}\dot{\bm{\xi}}_{E}=\dot{\bm{\xi}}_{d}-\mathbf{J}(\mathbf{q})\dot{\mathbf{q}}
Ley de control: imponemos una dinámica deseada para el error
\dot{\bm{e}}=-\mathbf{Ke}
\dot{\mathbf{q}}=\mathbf{J}^{\dagger}(\mathbf{q})({}^{B}_{}\dot{\bm{\xi}}_{E_d}+\mathbf{Ke})
\dot{\bm{e}} = \dot{\bm{\xi}}_{d}-{}^{B}_{}\dot{\bm{\xi}}_{E}=\dot{\bm{\xi}}_{d}-\mathbf{J}(\mathbf{q})\dot{\mathbf{q}}
Ley de control: imponemos una dinámica deseada para el error
\dot{\bm{e}}=-\mathbf{Ke}
\dot{\mathbf{q}}=\mathbf{J}^{\dagger}(\mathbf{q})({}^{B}_{}\dot{\bm{\xi}}_{E_d}+\mathbf{Ke})
sistema LTI
???
\mathbf{J}^{\dagger}(\mathbf{q})
pseudo-inversa de Moore Penrose
\approx{\mathbf{J}}^{-1}(\mathbf{q})
lo más cercano numéricamente
a la inversa de una matriz no cuadrada
Ji = pinv(J)\dot{\mathbf{q}}=\mathbf{J}^{\dagger}(\mathbf{q})(\dot{\bm{\xi}}_{d}+\mathbf{Ke})
integramos mediante forward Euler o RK4 y obtenemos un método iterativo para calcular la configuración en función de la pose
\mathbf{q}_{k+1}=\mathbf{q}_k+\mathbf{J}^{\dagger}(\mathbf{q}_k)({\bm{\xi}}_d[k]+\mathbf{Ke}_k)
\dot{\mathbf{q}}=\mathbf{J}^{\dagger}(\mathbf{q})(\dot{\bm{\xi}}_{d}+\mathbf{Ke})
integramos mediante forward Euler o RK4 y obtenemos un método iterativo para calcular la configuración en función de la pose
\mathbf{q}_{k+1}=\mathbf{q}_k+\mathbf{J}^{\dagger}(\mathbf{q}_k)({\bm{\xi}}_d[k]+\mathbf{Ke}_k)
Arquitectura general de los algoritmos de cinemática inversa
\text{Si }\bm{\xi}_d=\text{cte} \text{, entonces }\dot{\bm{\xi}}_d=0
\mathbf{q}_{k+1}=\mathbf{q}_k+\mathbf{J}^{\dagger}(\mathbf{q}_k)\mathbf{Ke}_k
\mathbf{q}_{k+1}=\mathbf{q}_k+\mathbf{J}^{\dagger}(\mathbf{q}_k)\mathbf{Ke}_k
Aparentemente todo está bien, pero si nos fijamos en el error...
\bm{e}[k]=\begin{bmatrix}
\bm{e}_p[k]\\
\bm{e}_o[k]\\
\end{bmatrix}=
\begin{bmatrix}
\bm{o}_d-{}^{B}_{}{\bm{o}_E(\mathbf{q}_k)}\\
\bm{\theta}_d-{}^{B}_{}{\bm{\theta}}_E(\mathbf{q}_k)
\end{bmatrix}
no es así de fácil
¿Cómo representamos al error de orientación entonces?
\bm{e}[k]=\begin{bmatrix}
\bm{e}_p[k]\\
\bm{e}_o[k]\\
\end{bmatrix}
¿Cómo representamos al error de orientación entonces?
\bm{e}[k]=\begin{bmatrix}
\bm{e}_p[k]\\
\bm{e}_o[k]\\
\end{bmatrix}
¿Cómo representamos al error de orientación entonces?
R\\
(\phi,\theta,\psi)\\
(\omega,\theta)
No, difícil de operar
No, conlleva singularidades
No, conlleva singularidades
No, hay que volver a R
\bm{e}[k]=\begin{bmatrix}
\bm{e}_p[k]\\
\bm{e}_o[k]\\
\end{bmatrix}
¿Cómo representamos al error de orientación entonces?
R\\
(\phi,\theta,\psi)\\
(\omega,\theta)
No, difícil de operar
No, conlleva singularidades
No, conlleva singularidades
No, hay que volver a R
¿Solución?
Cuaterniones unitarios
\bm{e}[k]=\begin{bmatrix}
\bm{e}_p[k]\\
\bm{e}_o[k]\\
\end{bmatrix}
¿Cómo representamos al error de orientación entonces?
\mathcal{Q}*\mathcal{Q}^{-1}=\{1,\bm{0}\}
\bm{\epsilon}=\{\bm{0}\}
Recordemos que:
Por lo que, si dos cuaterniones están alineados, su parte compleja valdrá 0
\bm{e}[k]=\begin{bmatrix}
\bm{e}_p[k]\\
\bm{e}_o[k]\\
\end{bmatrix}
¿Cómo representamos al error de orientación entonces?
\mathcal{Q}*\mathcal{Q}^{-1}=\{1,\bm{0}\}
\bm{\epsilon}=\{\bm{0}\}
Recordemos que:
Por lo que, si dos cuaterniones están alineados, su parte compleja valdrá 0
\bm{e}_o\sim\bm{\epsilon}_e\rightarrow\mathcal{Q}_d*\mathcal{Q}^{-1}_k
¿Cómo funciona el ikine de la Robotics Toolbox?
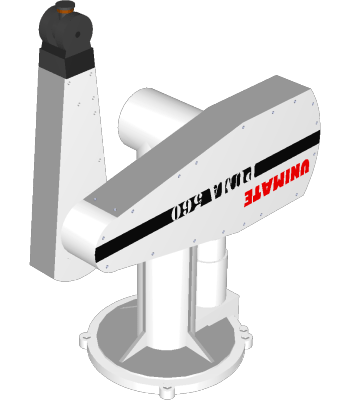
\mathbf{q}_0
\mathbf{q}_0
\mathbf{T}_0={^B}\mathbf{T}_E(\mathbf{q}_0)=
\begin{bmatrix} {^B}\mathbf{R}_E(\mathbf{q}_0) & {^B}\mathbf{o}_E(\mathbf{q}_0) \\ \mathbf{0} & 1 \end{bmatrix}
\mathbf{q}_0
\mathbf{T}_0={^B}\mathbf{T}_E(\mathbf{q}_0)=
\begin{bmatrix} {^B}\mathbf{R}_E(\mathbf{q}_0) & {^B}\mathbf{o}_E(\mathbf{q}_0) \\ \mathbf{0} & 1 \end{bmatrix}
\mathbf{q}_0
\mathbf{T}_d={^B}\mathbf{T}_E(\mathbf{q}_d)\\
=\begin{bmatrix} \mathbf{R}_d & \mathbf{o}_d \\ \mathbf{0} & 1 \end{bmatrix}
\mathbf{T}_0={^B}\mathbf{T}_E(\mathbf{q}_0)=
\begin{bmatrix} {^B}\mathbf{R}_E(\mathbf{q}_0) & {^B}\mathbf{o}_E(\mathbf{q}_0) \\ \mathbf{0} & 1 \end{bmatrix}
\mathbf{q}_0
\mathbf{T}_0={^B}\mathbf{T}_E(\mathbf{q}_0)=
\begin{bmatrix} {^B}\mathbf{R}_E(\mathbf{q}_0) & {^B}\mathbf{o}_E(\mathbf{q}_0) \\ \mathbf{0} & 1 \end{bmatrix}
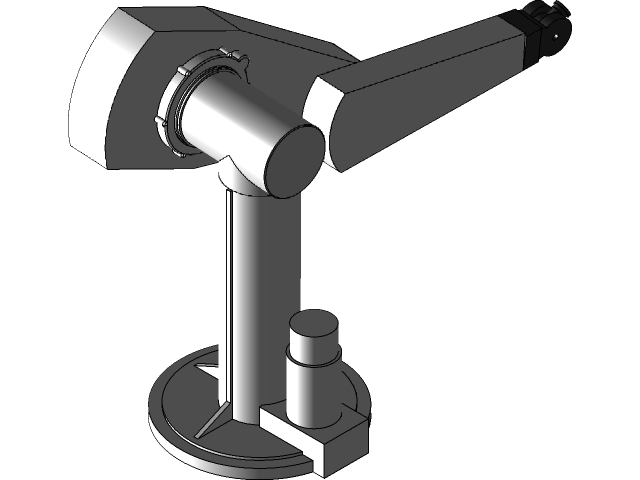
\mathbf{q}_f
\mathbf{T}_d={^B}\mathbf{T}_E(\mathbf{q}_d)\\
=\begin{bmatrix} \mathbf{R}_d & \mathbf{o}_d \\ \mathbf{0} & 1 \end{bmatrix}
\mathbf{q}_0
\mathbf{T}_0={^B}\mathbf{T}_E(\mathbf{q}_0)=
\begin{bmatrix} {^B}\mathbf{R}_E(\mathbf{q}_0) & {^B}\mathbf{o}_E(\mathbf{q}_0) \\ \mathbf{0} & 1 \end{bmatrix}
\mathbf{q}_f
ikine
{^B}\mathbf{T}_E \to \mathbf{T}_d
(en general)
\mathbf{q} \to \mathbf{q}_d
NO necesariamente
Para que el problema tenga solución y se acople a los GDL del robot, la Robotics Toolbox emplea la noción de máscaras
\mathbf{T}_d={^B}\mathbf{T}_E(\mathbf{q}_d)\\
=\begin{bmatrix} \mathbf{R}_d & \mathbf{o}_d \\ \mathbf{0} & 1 \end{bmatrix}
\mathbf{q}_0
\mathbf{T}_0={^B}\mathbf{T}_E(\mathbf{q}_0)=
\begin{bmatrix} {^B}\mathbf{R}_E(\mathbf{q}_0) & {^B}\mathbf{o}_E(\mathbf{q}_0) \\ \mathbf{0} & 1 \end{bmatrix}
\mathbf{q}_f
ikine
{^B}\mathbf{T}_E \to \mathbf{T}_d
(en general)
\mathbf{q} \to \mathbf{q}_d
NO necesariamente
\mathbf{T}_d={^B}\mathbf{T}_E(\mathbf{q}_d)\\
=\begin{bmatrix} \mathbf{R}_d & \mathbf{o}_d \\ \mathbf{0} & 1 \end{bmatrix}
>> be3027_clase7_p560ik.m
Obteniendo intuición detrás de los algoritmos
idea fundamental (prestando atención sólo a la posición)
{^B}\mathbf{v}_E=\mathbf{J}_v(\mathbf{q})\dot{\mathbf{q}}
\dfrac{\Delta {^B}\mathbf{o}_E}{\Delta t}=\mathbf{J}_v(\mathbf{q}) \dfrac{\Delta \mathbf{q}}{\Delta t}
idea fundamental (prestando atención sólo a la posición)
{^B}\mathbf{v}_E=\mathbf{J}_v(\mathbf{q})\dot{\mathbf{q}}
\dfrac{\Delta {^B}\mathbf{o}_E}{\Delta t}=\mathbf{J}_v(\mathbf{q}) \dfrac{\Delta \mathbf{q}}{\Delta t}
\Delta {^B}\mathbf{o}_E=\mathbf{J}_v(\mathbf{q}) \Delta \mathbf{q}
\Rightarrow \Delta \mathbf{q}=\mathbf{J}^\dagger_v(\mathbf{q}) \Delta {^B}\mathbf{o}_E
pseudo-inversa del jacobiano >> pinv(Jv)
\(\mathbf{T}_d\equiv\) meta
\({^B}\mathbf{T}_E(\mathbf{q})\)
efector final
el algoritmo debe llevar al efector final a la pose deseada o "meta"
\(\mathbf{T}_d\equiv\) meta
\({^B}\mathbf{T}_E(\mathbf{q})\)
efector final
Nota 1: el robot sólo puede cambiar su configuración
Nota 2: por el momento nos interesa sólo la posición
{^B}\mathbf{o}_E(\mathbf{q}_1)
\mathbf{o}_d
configuración actual: \(\mathbf{q}_1\)
¿Cuál es la discrepancia entre la posición deseada y la posición actual?
{^B}\mathbf{o}_E(\mathbf{q}_1)
\mathbf{o}_d
configuración actual: \(\mathbf{q}_1\)
¿Cuál es la discrepancia entre la posición deseada y la posición actual?
{^B}\mathbf{o}_E(\mathbf{q}_1)
\mathbf{o}_d
configuración actual: \(\mathbf{q}_1\)
\mathbf{e}_p=\mathbf{o}_d-{^B}\mathbf{o}_E(\mathbf{q}_1)
¿Cuál es la discrepancia entre la posición deseada y la posición actual?
{^B}\mathbf{o}_E(\mathbf{q}_1)
\mathbf{o}_d
configuración actual: \(\mathbf{q}_1\)
\mathbf{e}_p=\mathbf{o}_d-{^B}\mathbf{o}_E(\mathbf{q}_1) \sim \Delta {^B}\mathbf{o}_E
{^B}\mathbf{o}_E(\mathbf{q}_1)
\mathbf{o}_d
configuración actual: \(\mathbf{q}_1\)
¿Hacia dónde, potencialmente, puede moverse el robot?
¿Hacia dónde, potencialmente, puede moverse el robot?
{^B}\mathbf{o}_E(\mathbf{q}_1)
\mathbf{o}_d
configuración actual: \(\mathbf{q}_1\)
\mathbf{A}_v^{-1}(\mathbf{q}_1)=\left(\mathbf{J}_v(\mathbf{q}_1)\mathbf{J}^\top_v(\mathbf{q}_1)\right)^{-1}
{^B}\mathbf{o}_E(\mathbf{q}_1)
\mathbf{o}_d
\mathbf{A}_v^{-1}(\mathbf{q}_1)=\left(\mathbf{J}_v(\mathbf{q}_1)\mathbf{J}^\top_v(\mathbf{q}_1)\right)^{-1}
entonces el robot hace un movimiento pequeño tomando todo en consideración
configuración actual: \(\mathbf{q}_2\)
{^B}\mathbf{o}_E(\mathbf{q}_1)
\mathbf{o}_d
\mathbf{A}_v^{-1}(\mathbf{q}_1)=\left(\mathbf{J}_v(\mathbf{q}_1)\mathbf{J}^\top_v(\mathbf{q}_1)\right)^{-1}
entonces el robot hace un movimiento pequeño tomando todo en consideración
configuración actual: \(\mathbf{q}_2\)
\mathbf{q}_2=\mathbf{q}_1+\Delta\mathbf{q}
\Delta\mathbf{q}=\mathbf{J}^\dagger_v(\mathbf{q}_1) \Delta {^B}\mathbf{o}_E \\
\Delta\mathbf{q}=\mathbf{J}^\dagger_v(\mathbf{q}_1) \mathbf{e}_p
\mathbf{q}_2=\mathbf{q}_1+\mathbf{J}^\dagger_v(\mathbf{q}_1)\mathbf{e}_p
y se repite el proceso hasta que el error/discrepancia sea lo suficientemente pequeño
pueden obtenerse algoritmos similares pero para la orientación o la pose completa
\mathbf{q}_{k+1}=\mathbf{q}_k+\mathbf{J}^\dagger\left(\mathbf{q}_k\right)\mathbf{e}_k
Todo algoritmo de cinemática inversa cumple con la estructura
donde \(\mathbf{q}_{k+1} \to \mathbf{q}_d\) conforme incrementa el número de iteraciones
BE3027 - Lecture 7 (2026)
By Miguel Enrique Zea Arenales