MT3006 - Robótica 2
Recuperando geometría desde imágenes
¿Por qué?
¿Cuándo puede "revertirse" el mapeo?
¿Cuándo puede "revertirse" el mapeo?
3 posibles casos
¿Cuándo puede revertirse el mapeo?
¿Cuándo puede revertirse el mapeo?
conocida \(3 \times 4\)
conocido \(3 \times 1\)
desconocido \(4 \times 1\)
¿Cuándo puede revertirse el mapeo?
conocida \(3 \times 4\)
conocido \(3 \times 1\)
desconocido \(4 \times 1\)
Es decir, ¿De pixeles a puntos? (caso 1)
¿Cuándo puede revertirse el mapeo?
conocida \(3 \times 4\)
conocido \(3 \times 1\)
desconocido \(4 \times 1\)
El mapeo \(\mathbf{C}\) no es único (consecuencia de la proyección)
Un pixel define un rayo
rayo
imagen
punto focal
un pixel define una familia de puntos
Un pixel define un rayo
rayo
imagen
punto focal
un pixel define una familia de puntos
el problema para "invertir" el mapeo proviene de la pérdida de profundidad
Un pixel define un rayo
rayo
imagen
punto focal
un pixel define una familia de puntos
el problema para "invertir" el mapeo proviene de la pérdida de profundidad
\(\Rightarrow\) necesitamos información adicional para romper esta ambigüedad
Rompiendo con la ambigüedad
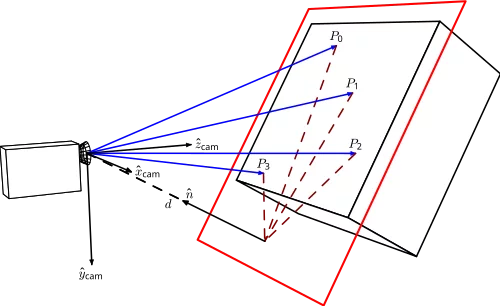
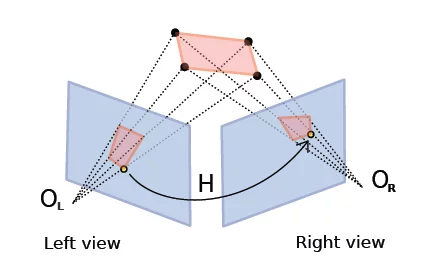
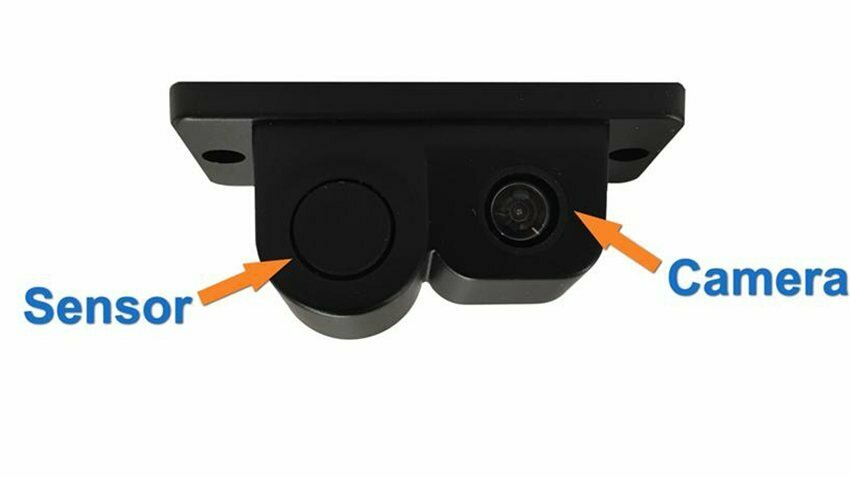
profundidad conocida, mediante un sensor de distancia o un modelo de escena
plano conocido (intersección rayo-plano)
triangulación empleando una vista adicional
Rompiendo con la ambigüedad
profundidad conocida, mediante un sensor de distancia o un modelo de escena
triangulación empleando una vista adicional
plano conocido (intersección rayo-plano)
Rompiendo con la ambigüedad
profundidad conocida, mediante un sensor de distancia o un modelo de escena
triangulación empleando una vista adicional
plano conocido (intersección rayo-plano)
homografía
¿Por qué?
¿Por qué?
mismo \(z\) para puntos coplanares, \(z=0\) por conveniencia
¿Por qué?
¿Por qué?
\(\mathbf{H}\equiv\) homografía
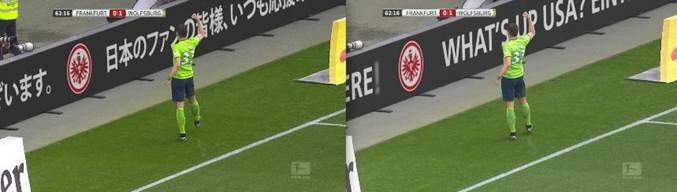
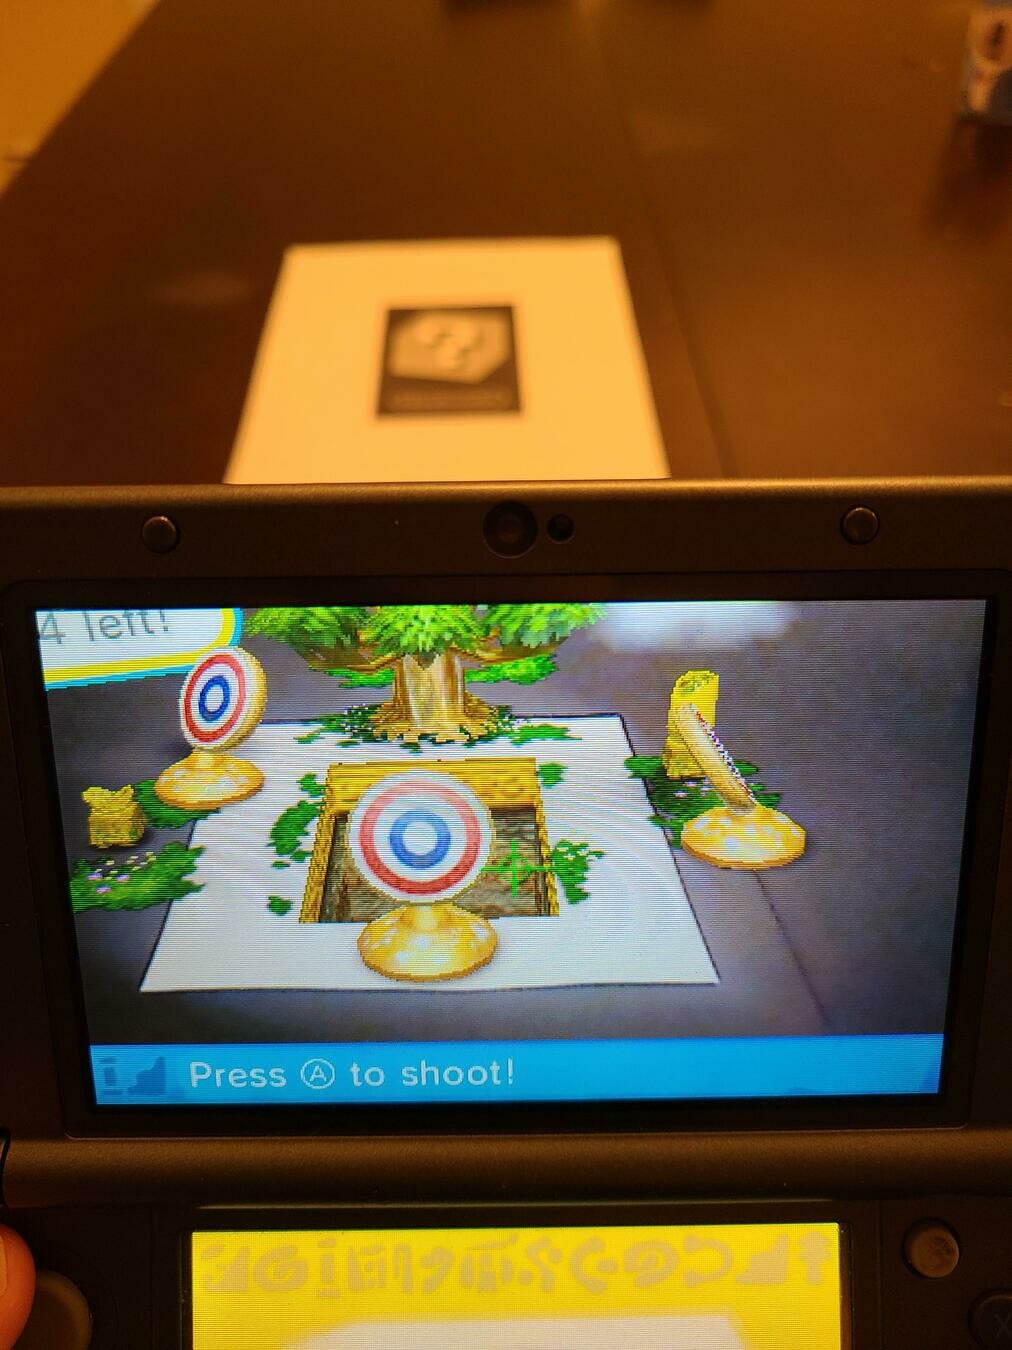
Ejemplo: realidad aumentada
Tipos de transformaciones en 2D
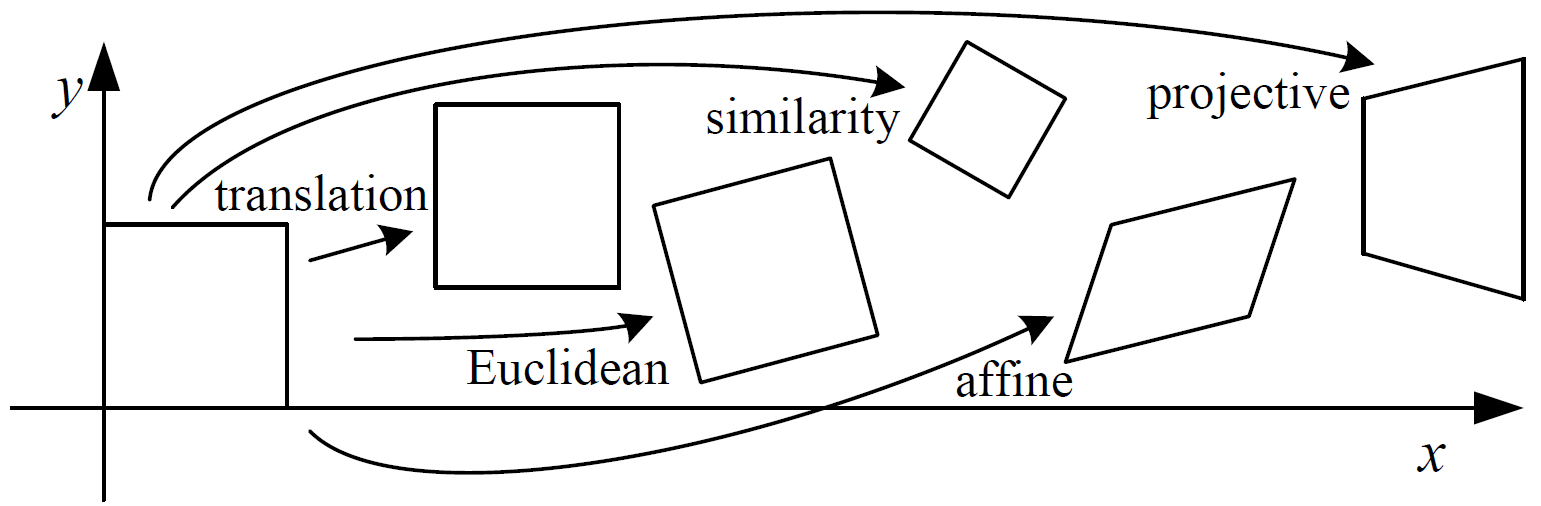
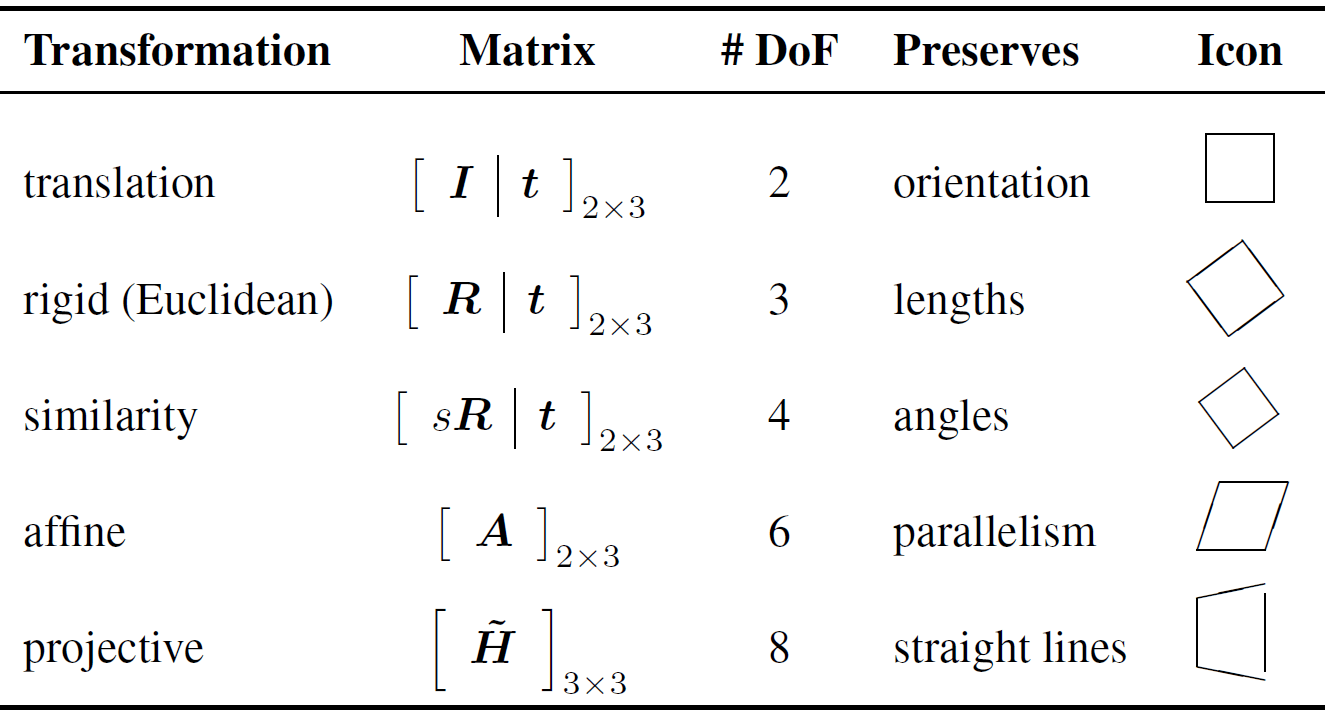
Tipos de transformaciones en 2D
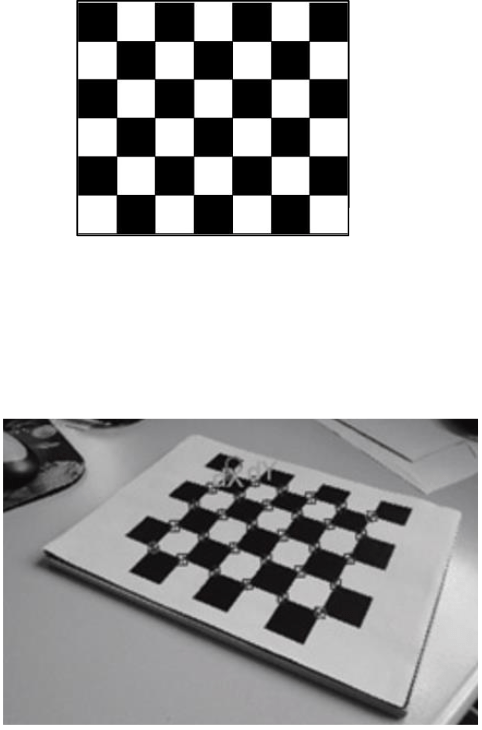
>> mt3006_clase3_homografia.m
Limitaciones de las homografías
Sí permite
No permite por sí sola
- Rectificar un plano observado con perspectiva.
- Mapear puntos entre dos vistas de un mismo plano.
- Modelar vistas bajo rotación pura de cámara.
- Recuperar la estructura 3D completa de una escena arbitraria.
- Medir en unidades métricas sin una referencia física.
- Resolver profundidad fuera del plano asumido.
Rompiendo con la ambigüedad
profundidad conocida, mediante un sensor de distancia o un modelo de escena
triangulación empleando una vista adicional
plano conocido (intersección rayo-plano)
Otra vista del mismo punto
Idea: Una segunda cámara o una segunda pose produce otro rayo. Si el mismo punto se observa en ambas imágenes, la intersección de los rayos determina el punto 3D.
Otra vista del mismo punto
Idea: Una segunda cámara o una segunda pose produce otro rayo. Si el mismo punto se observa en ambas imágenes, la intersección de los rayos determina el punto 3D.
triangulación
Otra vista del mismo punto
Idea: Una segunda cámara o una segunda pose produce otro rayo. Si el mismo punto se observa en ambas imágenes, la intersección de los rayos determina el punto 3D.
>> mt3006_clase3_triangulacion.m
Geometría epipolar
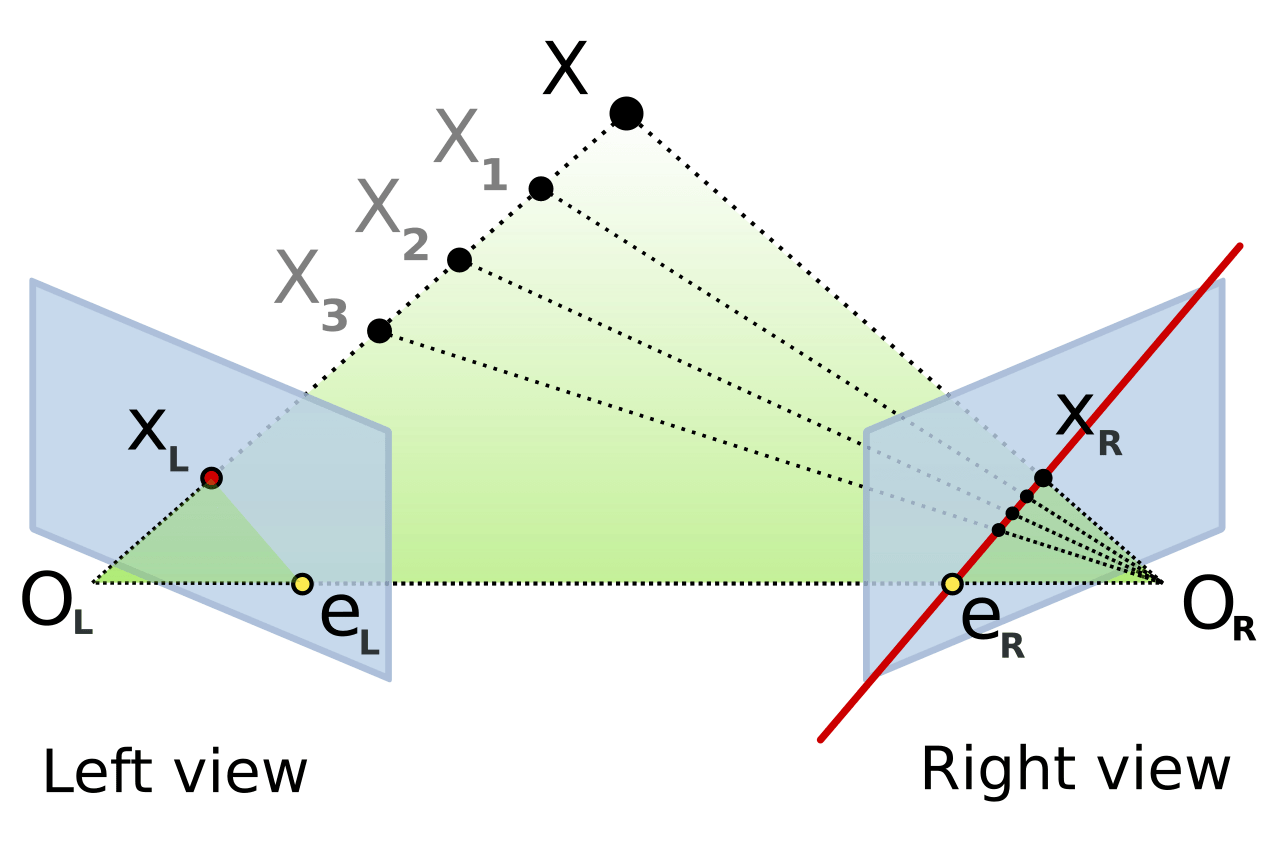
Dado un punto en la primera imagen, su correspondencia en la segunda debe caer sobre una línea epipolar.
Para puntos normalizados \(\tilde{\mathbf{x}}=\mathbf{K}^{-1}\tilde{\mathbf{s}}\) y cámaras calibradas:
Triangulación y escala
- Si se conocen las dos matrices de proyección, las correspondencias 2D–2D permiten triangular puntos 3D.
- En visión monocular, si la pose relativa se estima sólo desde imágenes, la escala absoluta permanece desconocida.
- La rotación se recupera de forma métrica, pero la traslación se obtiene como dirección, no como magnitud absoluta.
¿Cuándo puede revertirse el mapeo?
¿Cuándo puede revertirse el mapeo?
desconocida \(3 \times 4=12\) parámetros (11 GDL)
\(=\)\(\mathbf{K}\) \({^C}\mathbf{T}_I\)
¿Cuándo puede revertirse el mapeo?
desconocida \(3 \times 4=12\) parámetros (11 GDL)
\(=\)\(\mathbf{K}\) \({^C}\mathbf{T}_I\)
si no se conoce nada sobre la cámara, los parámetros son una mezcla de los intrínsecos con los extrínsecos
¿Cuándo puede revertirse el mapeo?
\(n\) conocidos \(3 \times 1\)
\(n\) conocidos \(4 \times 1\)
desconocida \(3 \times 4=12\) parámetros (11 GDL)
\(=\)\(\mathbf{K}\) \({^C}\mathbf{T}_I\)
Idea: usar correspondencias entre puntos para plantear un sistema de ecuaciones y estimar los parámetros
¿Cuándo puede revertirse el mapeo?
\(n\) conocidos \(3 \times 1\)
\(n\) conocidos \(4 \times 1\)
desconocida \(3 \times 4=12\) parámetros (11 GDL)
\(=\)\(\mathbf{K}\) \({^C}\mathbf{T}_I\)
encontrar intrínsecos* + extrínsecos
\(\Rightarrow\) calibración de cámara (caso 2)
¿Cuándo puede revertirse el mapeo?
\(n\) conocidos \(3 \times 1\)
\(n\) conocidos \(4 \times 1\)
desconocida \(3 \times 4=12\) parámetros (11 GDL)
\(=\)\(\mathbf{K}\) \({^C}\mathbf{T}_I\)
*la distorsión de la lente suele encontrarse por separado
DLT y calibración planar
- Se emplea el algoritmo Direct Linear Transform (DLT) para transformar el mapeo de proyección a un sistema lineal homogéneo, para resolver con métodos estándar.
- Se emplea un patrón conocido y varias imágenes del mismo.
- El método de Zhang aprovecha un patrón plano observado desde diferentes poses.
OpenCV emplea el mismo método de calibración
¿Cuándo puede revertirse el mapeo?
¿Cuándo puede revertirse el mapeo?
desconocida \(4 \times 4=16\) parámetros (6 GDL)
\(=\)\(\mathbf{K}\) \({^C}\mathbf{T}_I\)
se conocen los intrínsecos (cámara calibrada), entonces los parámetros corresponden a los extrínsecos (pose de la cámara)
¿Cuándo puede revertirse el mapeo?
desconocida \(4 \times 4=16\) parámetros (6 GDL)
\(=\)\(\mathbf{K}\) \({^C}\mathbf{T}_I\)
\(n\) conocidos \(3 \times 1\)
\(n\) conocidos \(4 \times 1\)
Idea: misma que antes, usar correspondencias entre puntos para estimar los parámetros
¿Cuándo puede revertirse el mapeo?
desconocida \(4 \times 4=16\) parámetros (6 GDL)
\(=\)\(\mathbf{K}\) \({^C}\mathbf{T}_I\)
\(n\) conocidos \(3 \times 1\)
\(n\) conocidos \(4 \times 1\)
intrínsecos conocidos, encontrar extrínsecos
\(\Rightarrow\) localización de cámara (caso 3)
¿Cuándo puede revertirse el mapeo?
desconocida \(4 \times 4=16\) parámetros (6 GDL)
\(=\)\(\mathbf{K}\) \({^C}\mathbf{T}_I\)
\(n\) conocidos \(3 \times 1\)
\(n\) conocidos \(4 \times 1\)
intrínsecos conocidos, encontrar extrínsecos
\(\Rightarrow\) localización de cámara (caso 3)
En general, puede hacerse resolviendo el problema de Perspective\(-n-\)Point (P\(n\)P)
Problema P\(n\)P
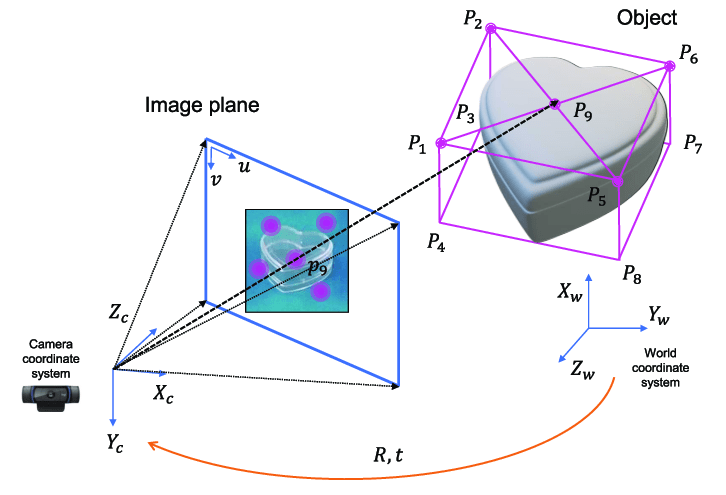
Se emplean \(n\) correspondencias entre puntos 3D y sus respectivas proyecciones en 2D para estimar los parámetros del mapeo
Problema P\(n\)P
- P3P: cuatro soluciones para puntos no colineales.
- P4P y P5P: dos soluciones para puntos no coplanares, única solución para cuatro puntos coplanares (no colineales).
- P\(n\)P: con \(n\ge 6\) puntos no coplanares tiene una única solución.
Problema P\(n\)P
- P3P: cuatro soluciones para puntos no colineales.
- P4P y P5P: dos soluciones para puntos no coplanares, única solución para cuatro puntos coplanares (no colineales).
- P\(n\)P: con \(n\ge 6\) puntos no coplanares tiene una única solución.
método de Zhang
método de Tsai
tags y (fiducial) markers como PnP empaquetado
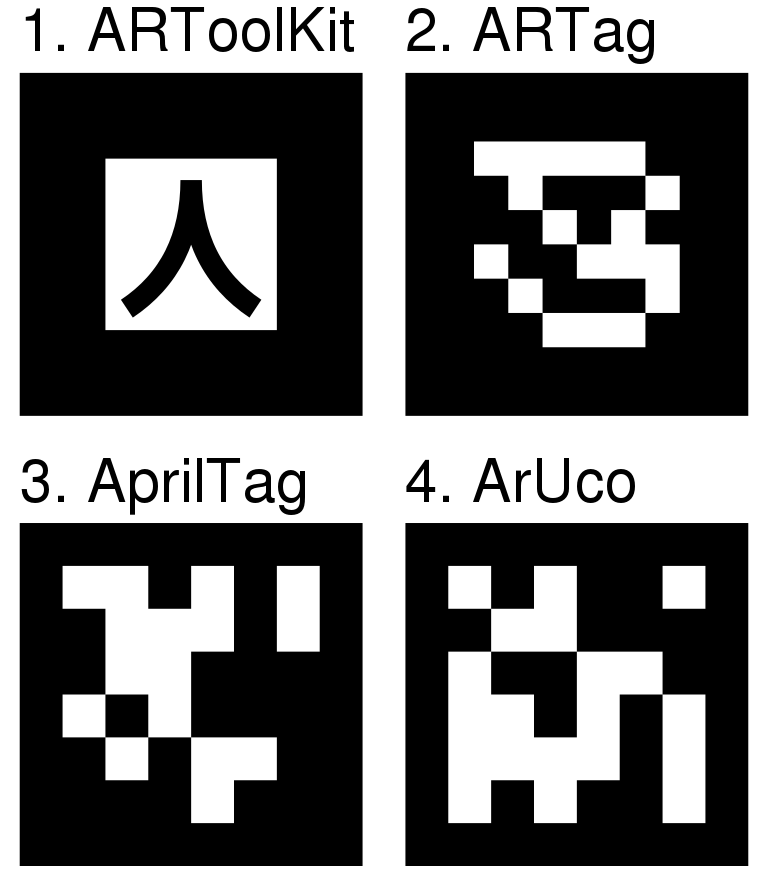
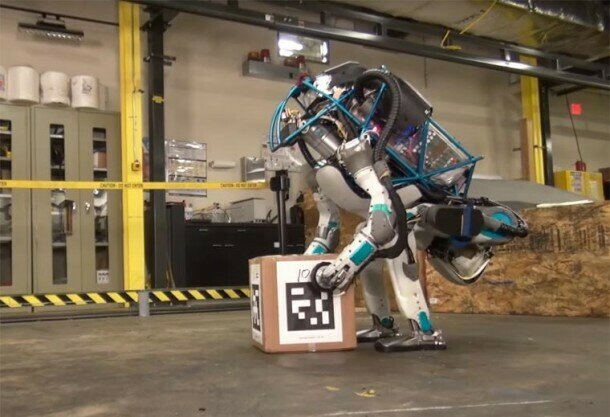
>> mt3006_clase3_apriltags.m
Localización de cámara
- Si bien puede emplearse DLT para resolver este problema, es subóptimo.
- Algunas alternativas de algoritmos son:
- P3P: SOLVEPNP_P3P (OpenCV), estworldpose (MATLAB), SOLVEPNP_AP3P (OpenCV).
- P\(n\)P con \(n\ge 4\): SOLVEPNP_EPNP (OpenCV, Efficient PnP). El EPnP es hasta 10 veces más robusto, exacto y eficiente que el DLT.
Ejemplo: headsets de realidad virtual
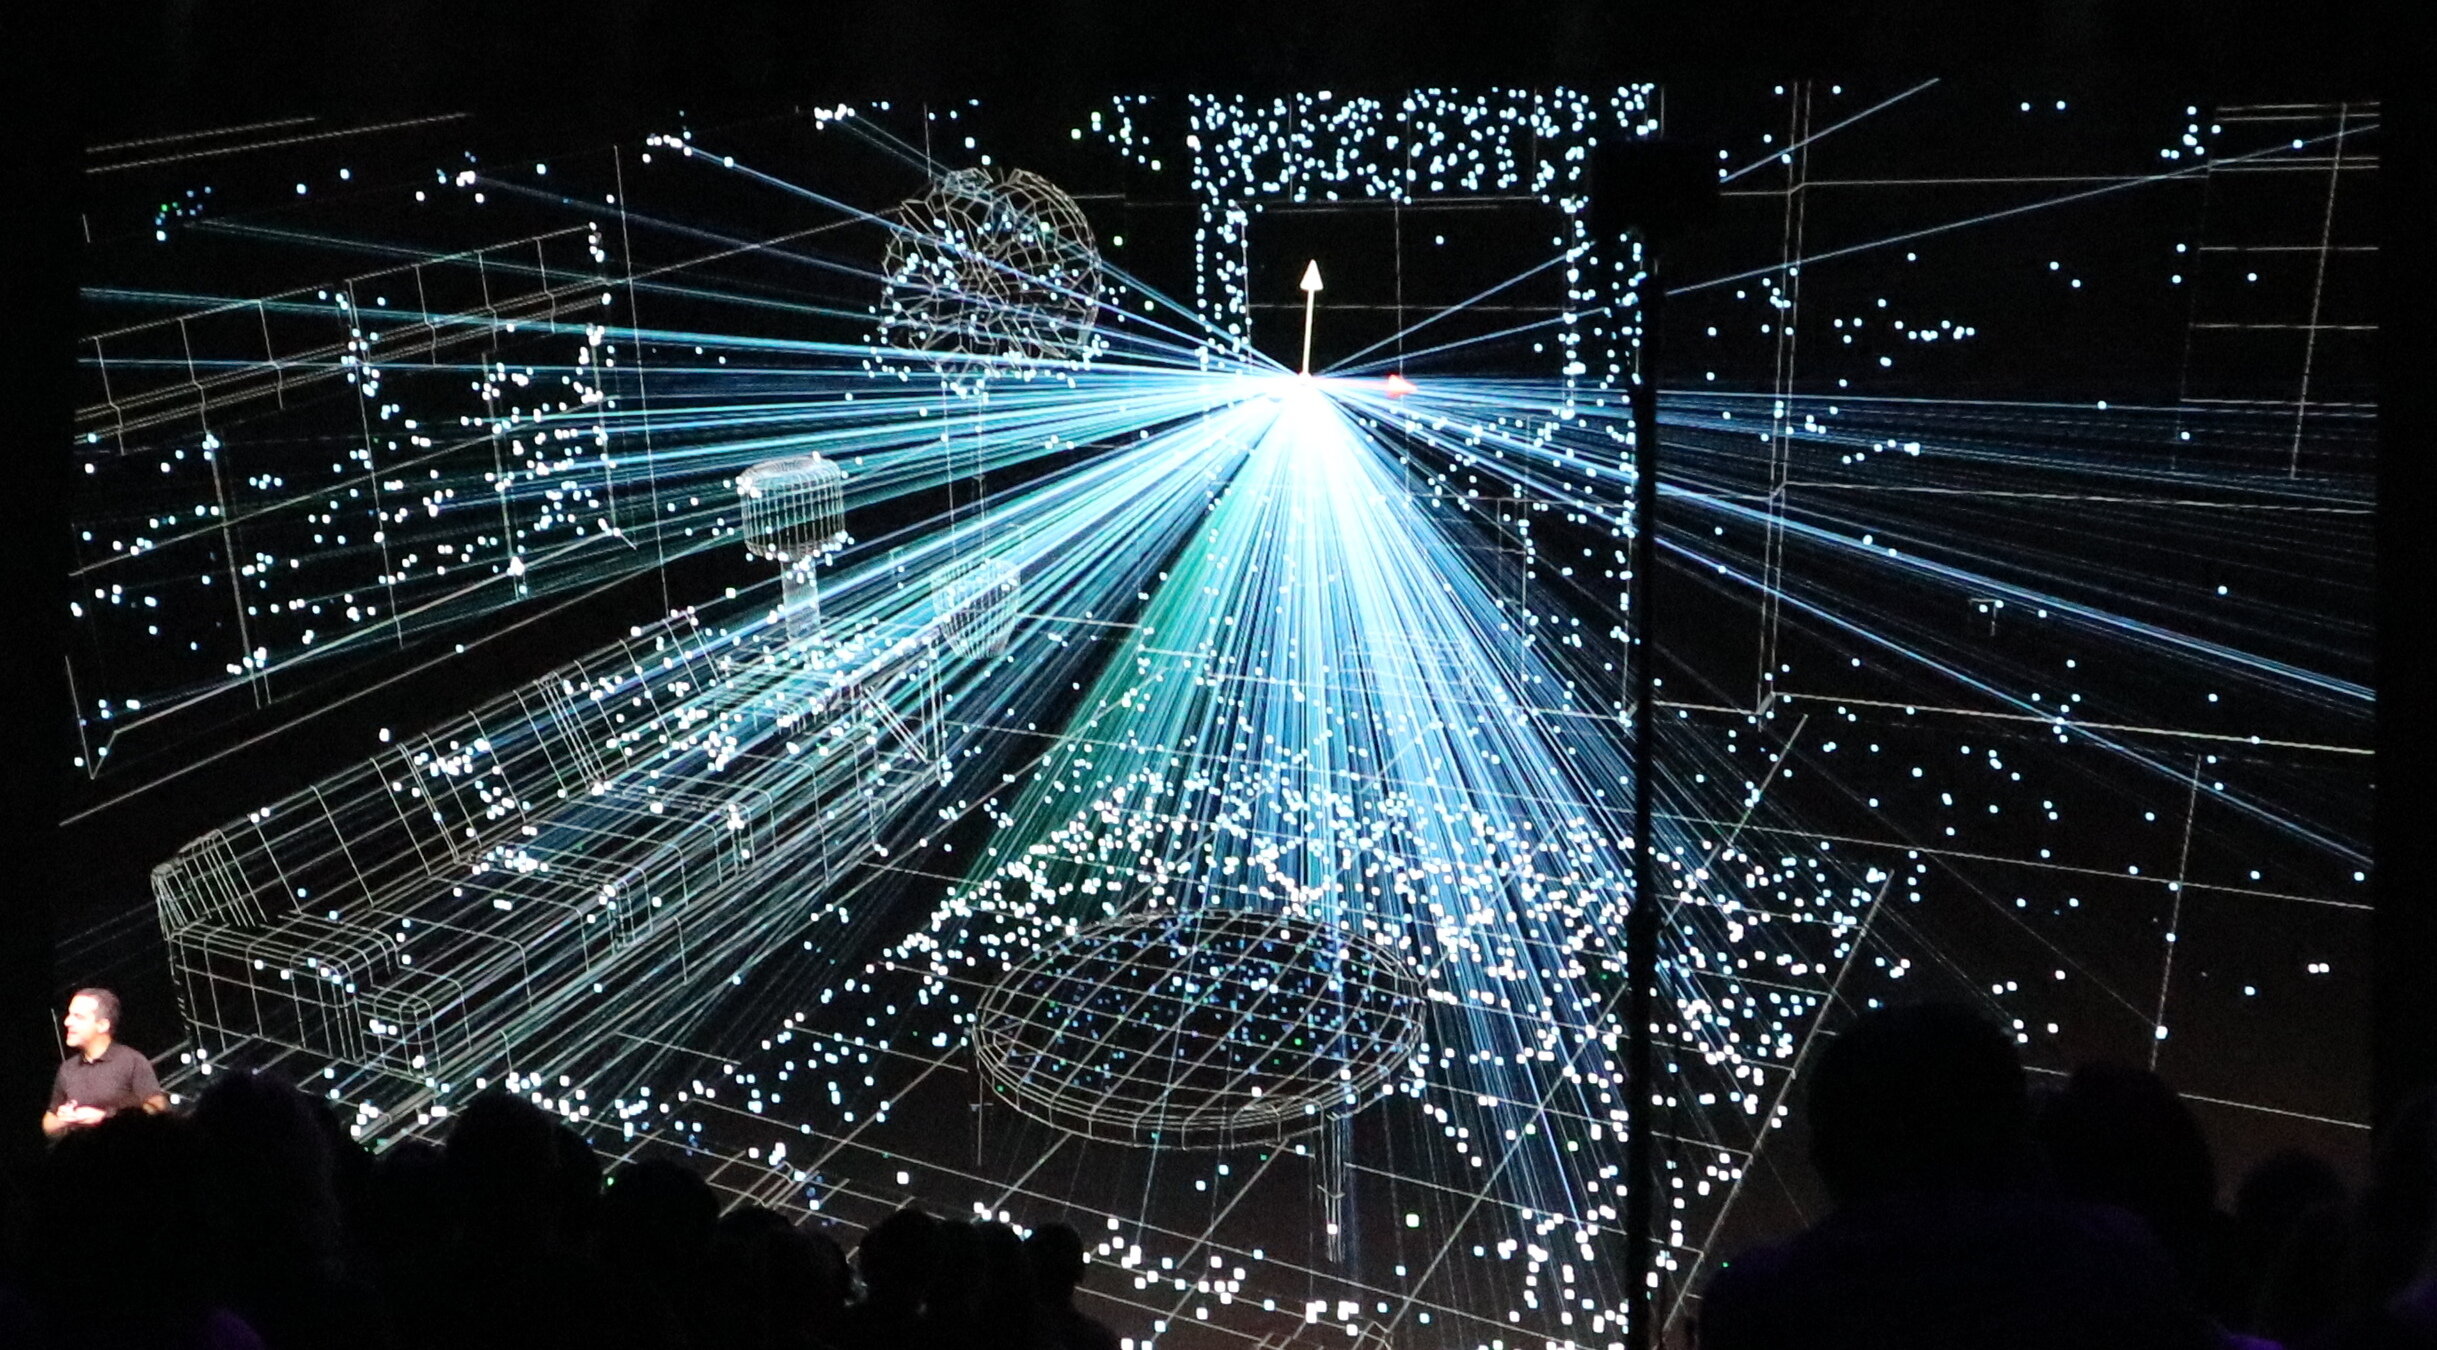
Ejemplo: odometría visual
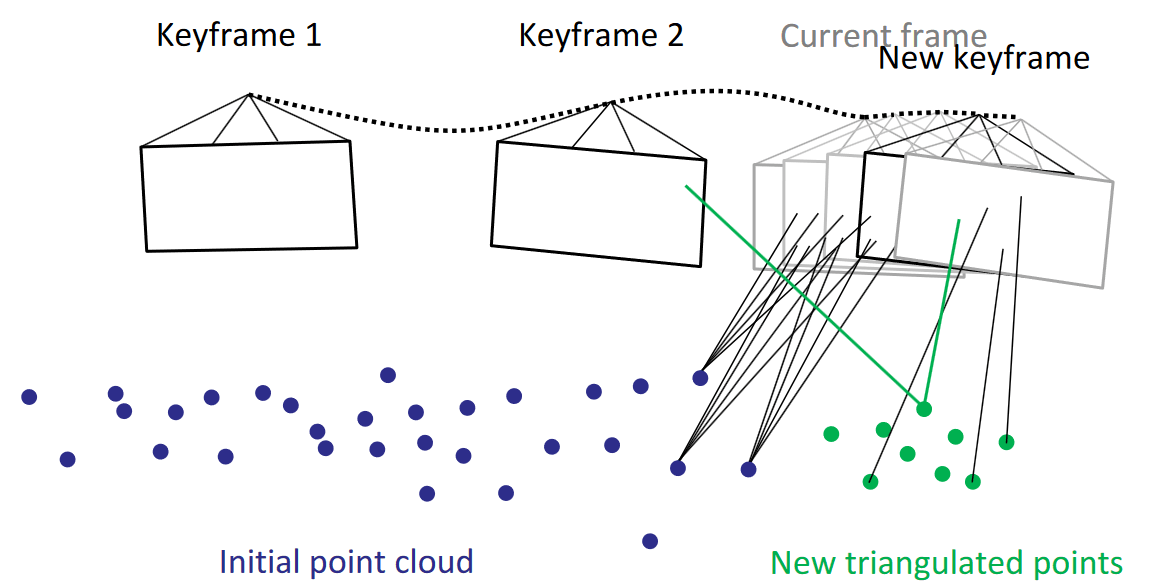
Ejemplo: odometría visual
Limitantes
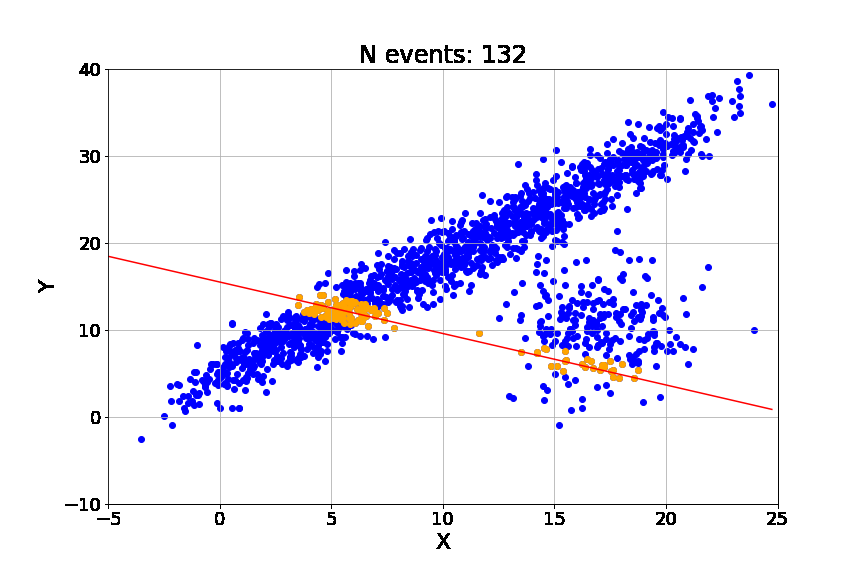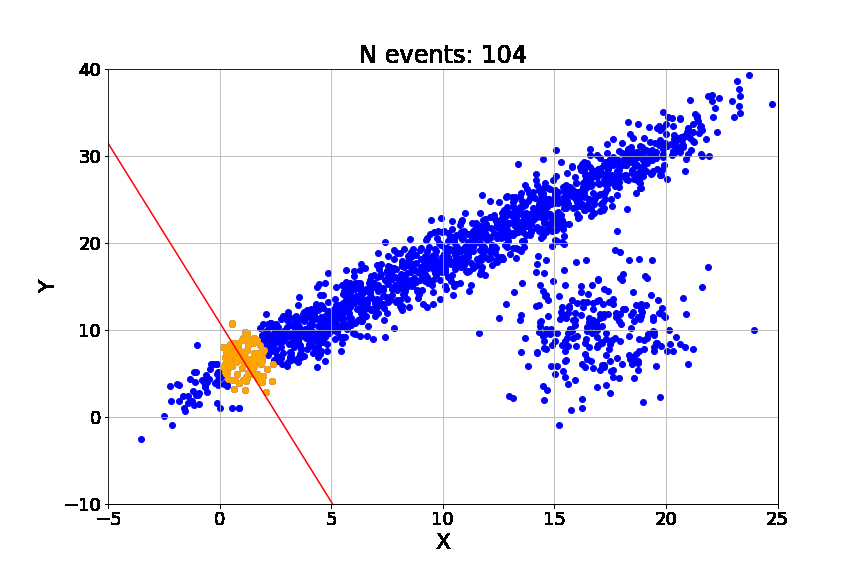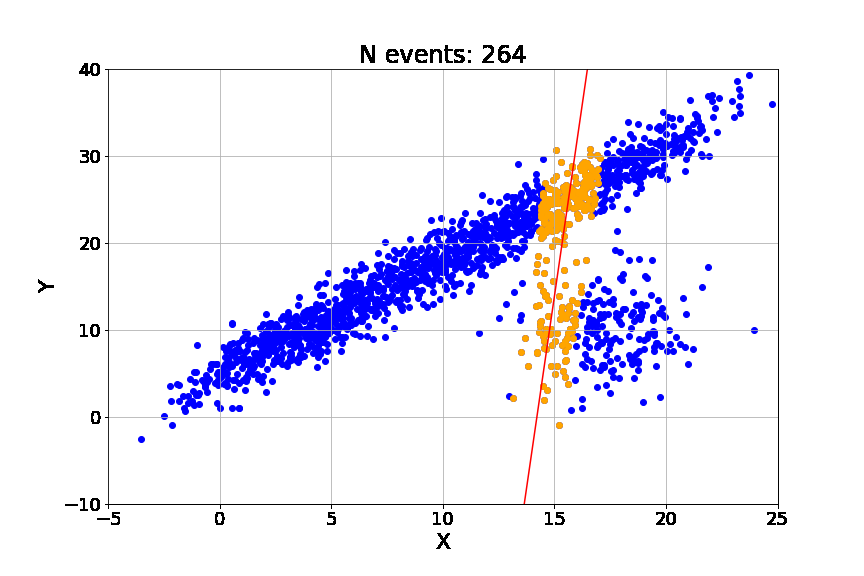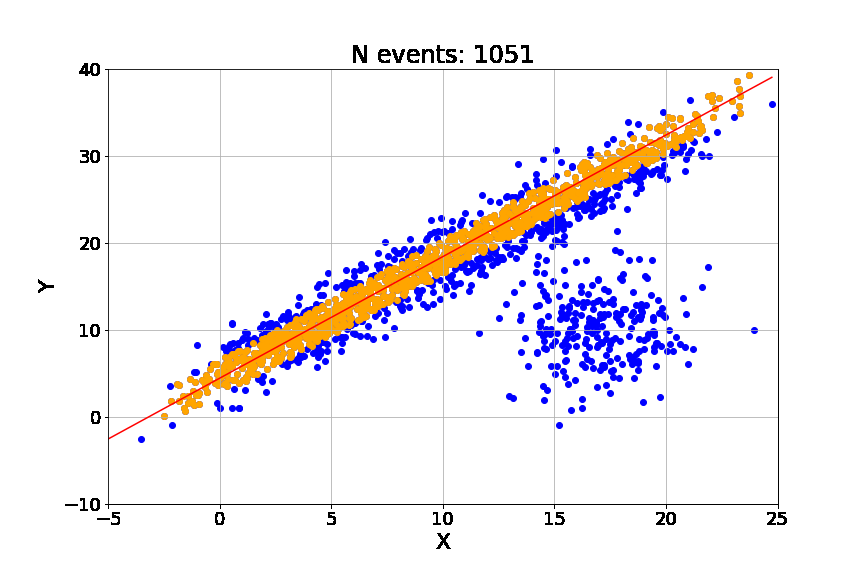
Por la naturaleza de las imágenes, puede que haya una cantidad considerable de puntos atípicos, dificultando las correspondencias 3D-2D.
Por lo tanto, suelen combinarse los algoritmos de P\(n\)P con el algoritmo RANSAC para obviar los puntos atípicos.
1.
Random Sample Consensus (RANSAC)
Algoritmo iterativo para la estimación paramétrica en la presencia de puntos atípicos.
Limitantes
¿Qué ocurre cuándo se tienen sólo imágenes, sin información 3D como para hacer correspondencias?
Pueden seguir utilizándose las correspondencias entre puntos pero ahora usando múltiples imágenes (de la misma situación), mediante características (features).
2.
Detección y correspondencia de características
(feature detection and matching)
Idea general: template matching
Idea general: template matching pero evitando sus problemas
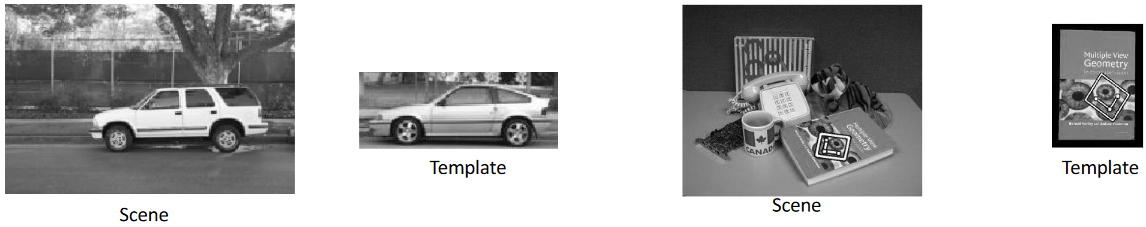
Idea general: template matching pero evitando sus problemas
- Cambios geométricos: rotación, escala, perspectiva
- Cambios de iluminación.
- Cambios de apariencia.
Idea general: template matching pero evitando sus problemas
- Cambios geométricos: rotación, escala, perspectiva
- Cambios de iluminación.
- Cambios de apariencia.
¿Una mejor opción?
Ejemplo: alineando dos imágenes
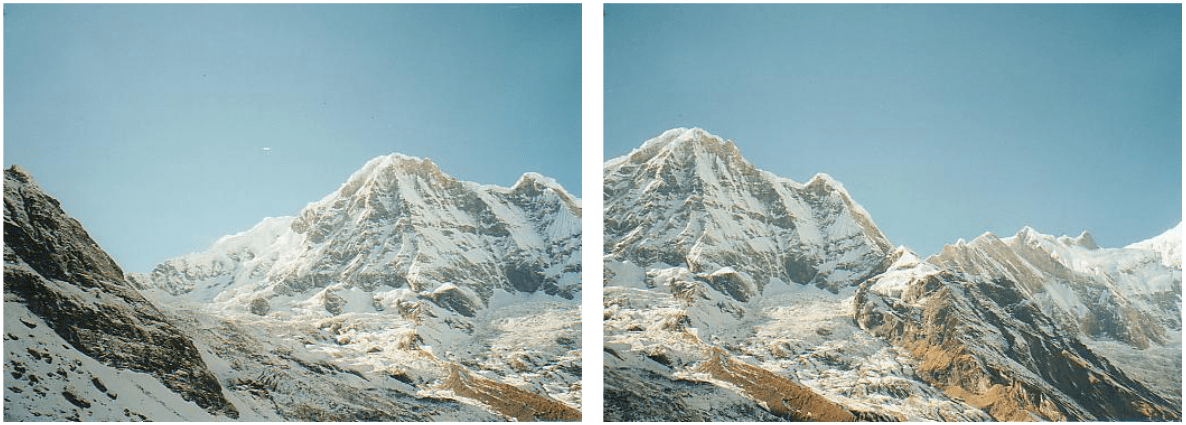
Ejemplo: alineando dos imágenes
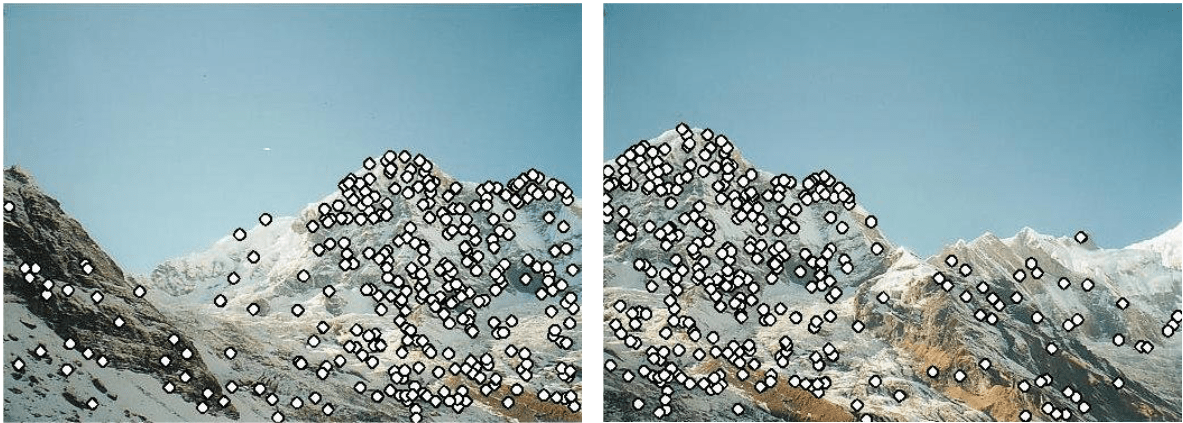
Ejemplo: alineando dos imágenes
keypoints
...
...
Ejemplo: alineando dos imágenes
keypoints
...
...
¿Cómo seleccionarlos?
Consideración 1: deben detectarse los mismos puntos de forma independiente en ambas imágenes
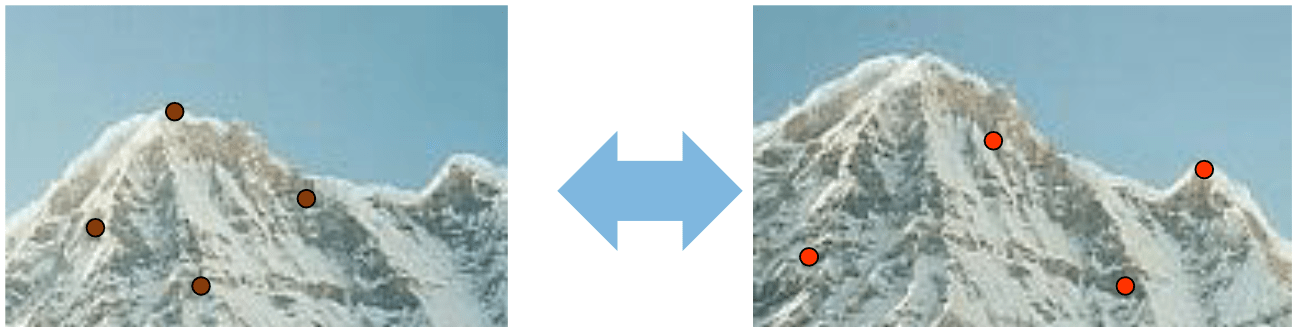
no puede hacerse la correspondencia si no son los mismos puntos
\(\Rightarrow\) se requiere un detector de features repetible
Consideración 2: debe poderse hacer la correspondencia del mismo punto en ambas imágenes
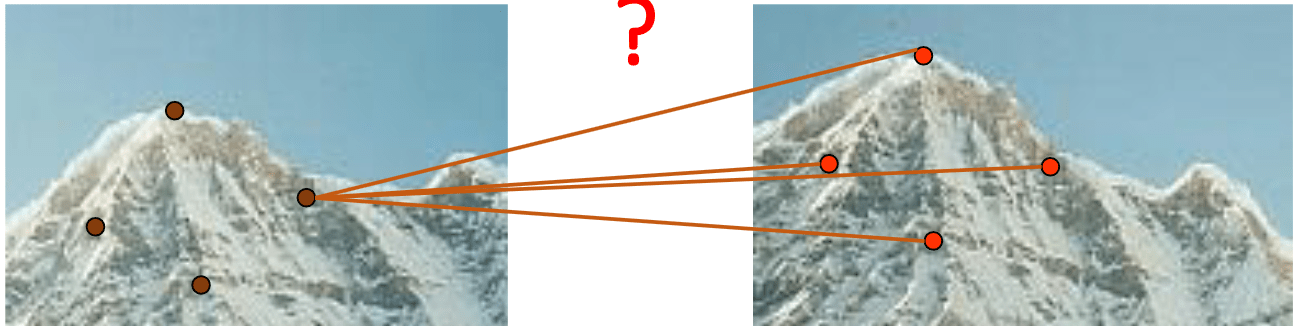
¿Cuál corresponde a cuál?
\(\Rightarrow\) se requiere un descriptor de features distintivo (e invariante a cambios geométricos y de iluminación)
?
Consideración 2: debe poderse hacer la correspondencia del mismo punto en ambas imágenes
¿Cuál corresponde a cuál?
\(\Rightarrow\) se requiere un descriptor de features distintivo (e invariante a cambios geométricos y de iluminación)
?
feature = keypoint + descriptor
Consideración 2: debe poderse hacer la correspondencia del mismo punto en ambas imágenes
¿Cuál corresponde a cuál?
\(\Rightarrow\) se requiere un descriptor de features distintivo (e invariante a cambios geométricos y de iluminación)
?
feature* = keypoint + descriptor
*dentro de este contexto, cambiará en el módulo de machine learning
¿Features repetibles y distintivas?
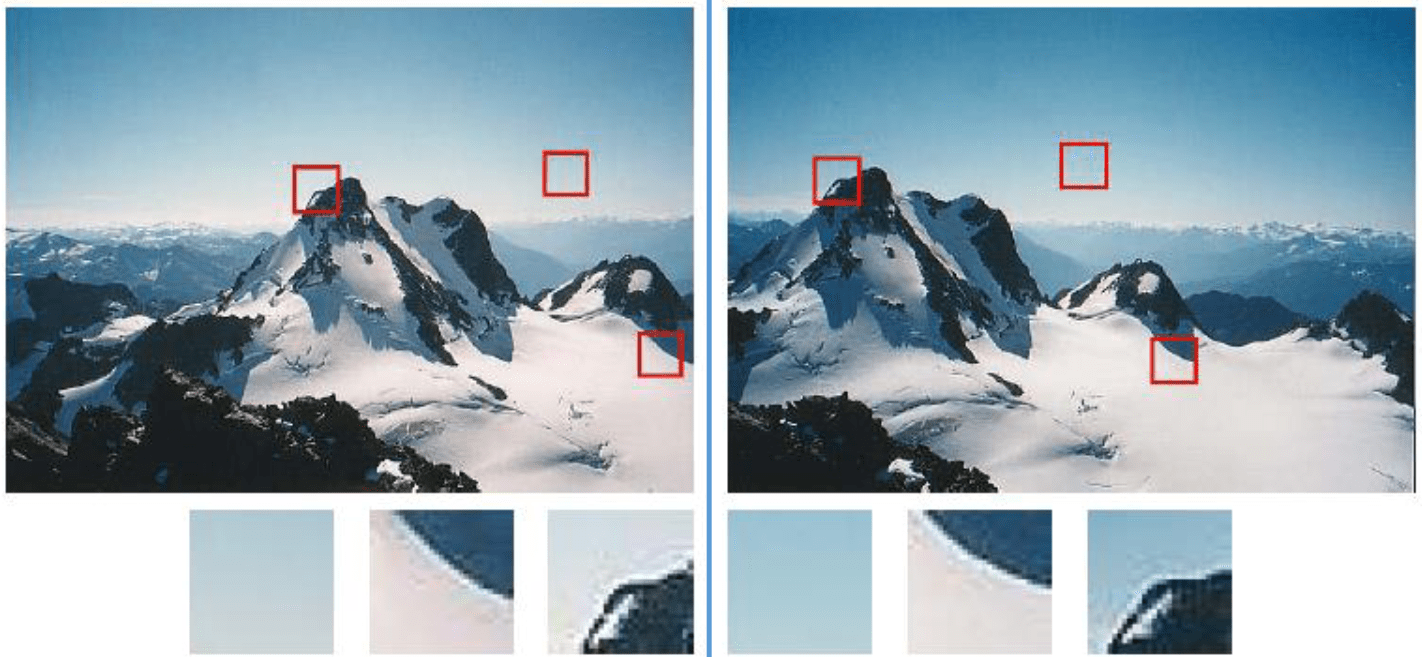
¿Features repetibles y distintivas?
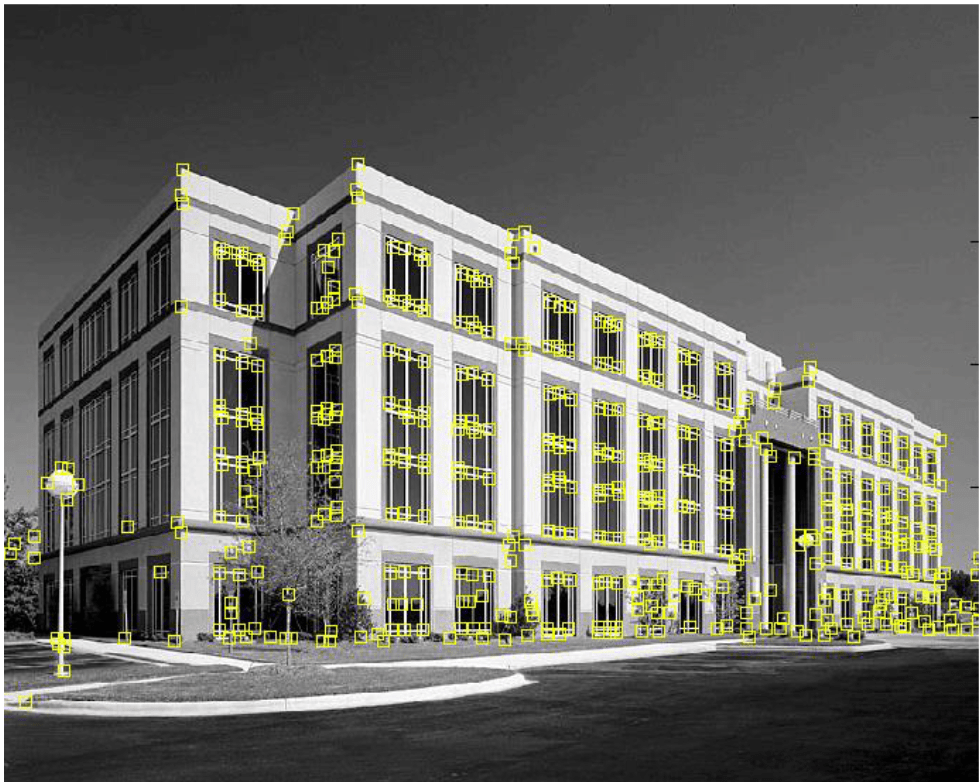
Ejemplo detector Harris (esquinas)
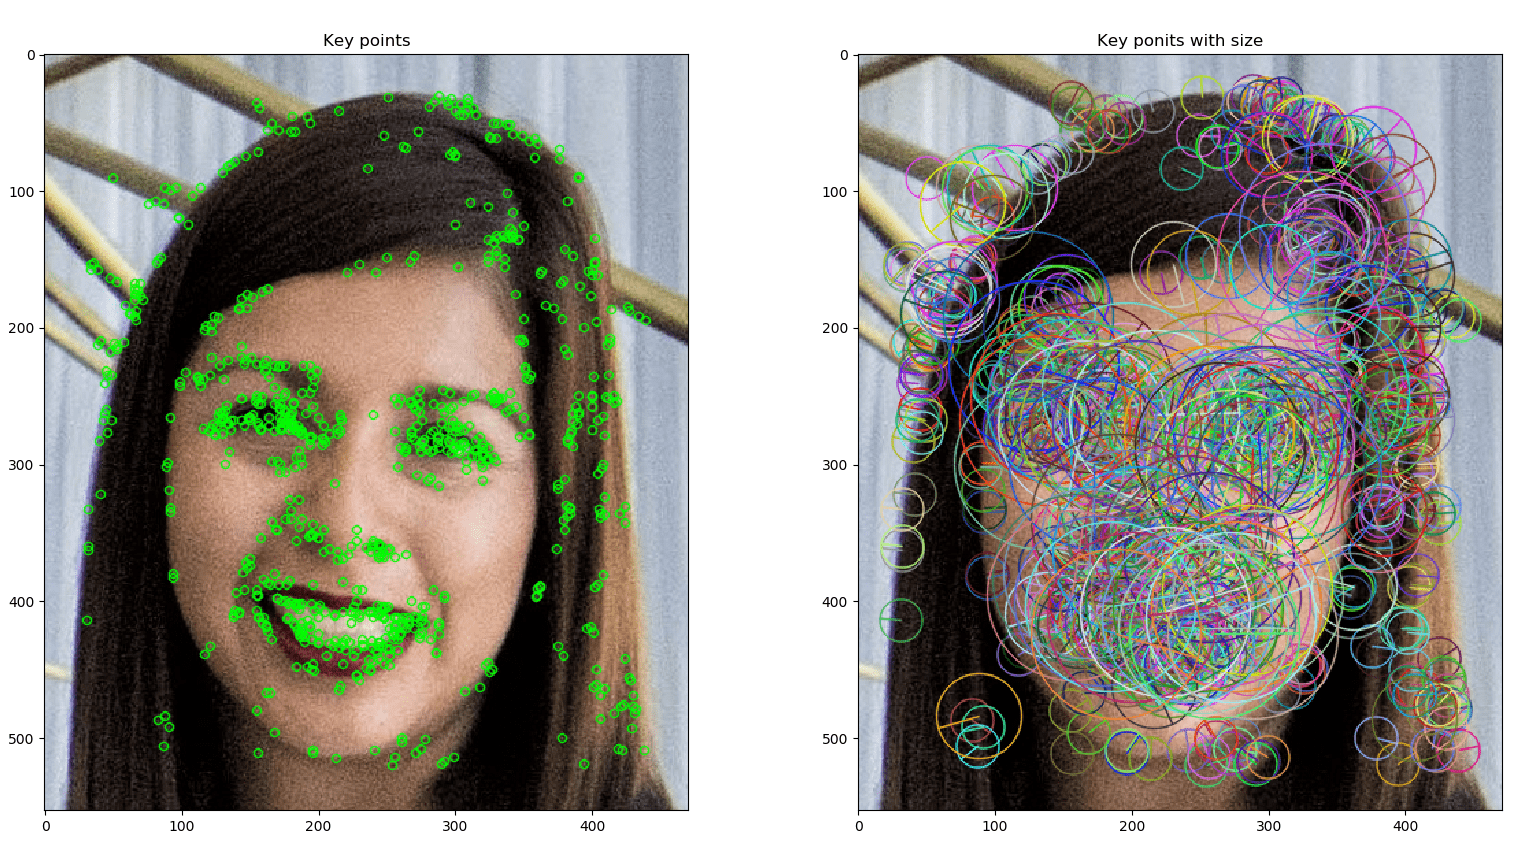
Ejemplo detector ORB (blobs)
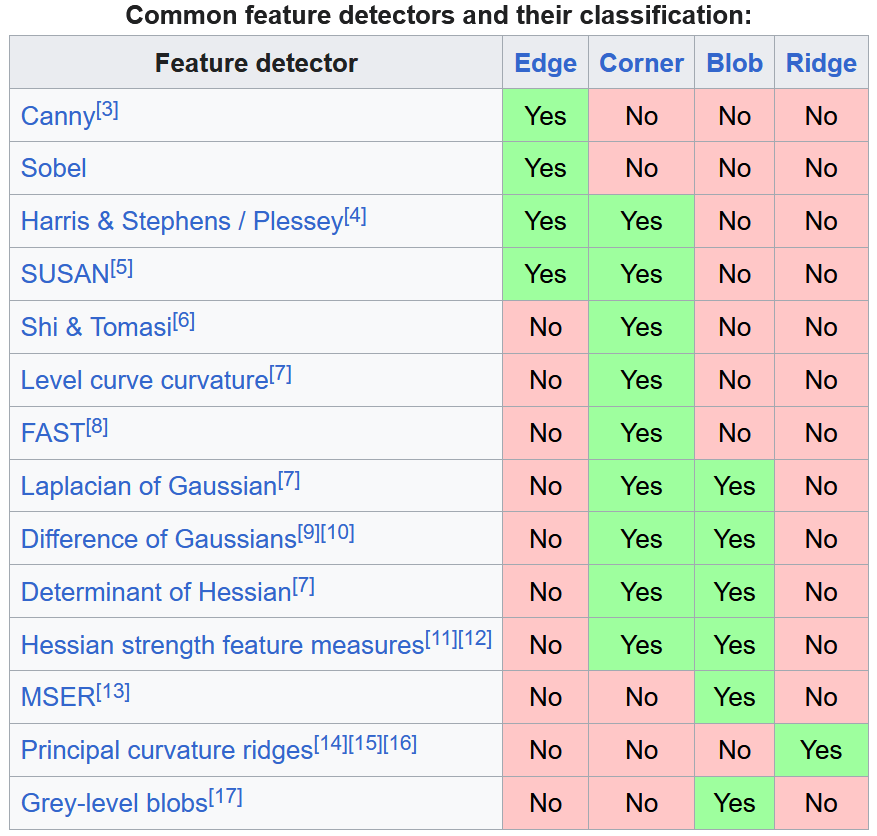
Comparación de algunos detectores
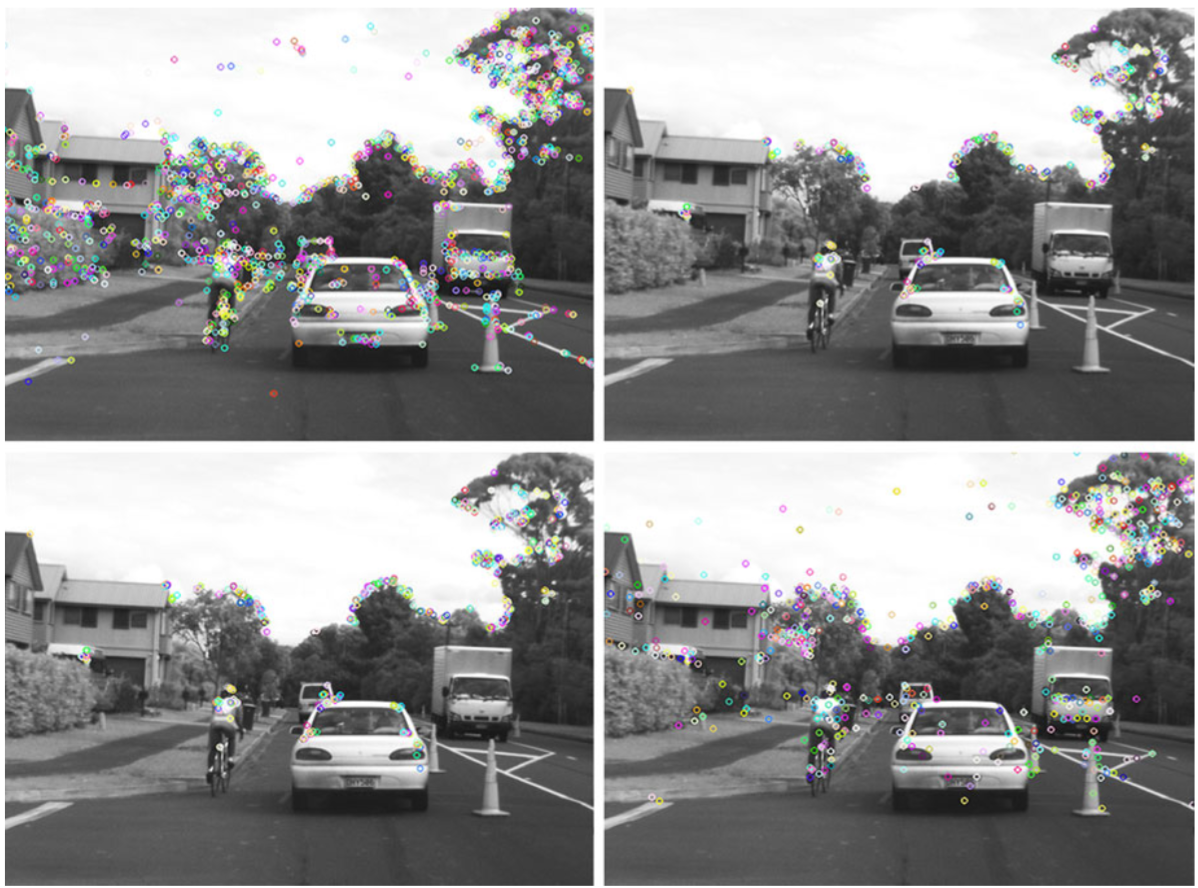
FAST
(esquinas)
ORB
(SIFT "gratis")
SIFT
(blobs)
SURF
(SIFT rápido)
Comparación de algunos detectores
FAST
(esquinas)
ORB
(SIFT "gratis")
SIFT
(blobs)
SURF
(SIFT rápido)
Regresando al ejemplo de alinear imágenes
Ejemplo: alineando dos imágenes
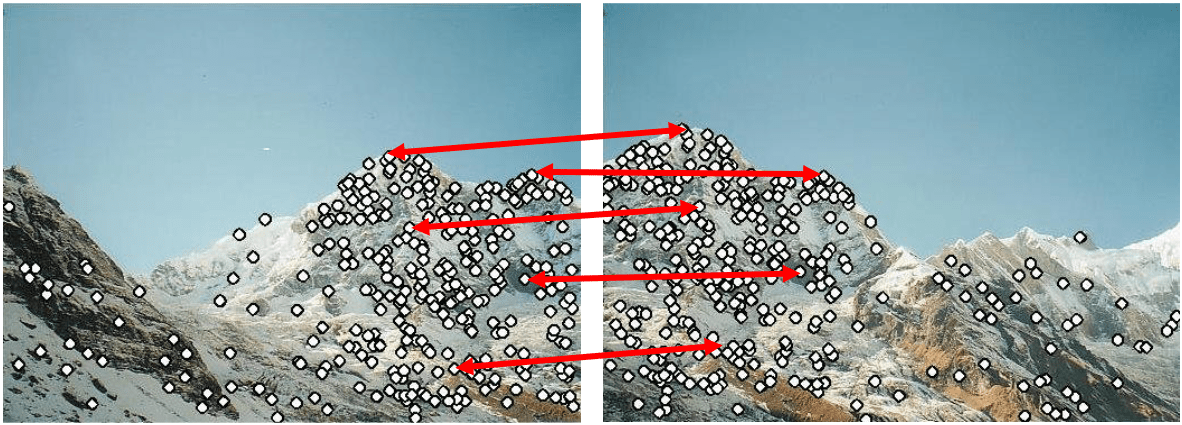
matching = se establecen correspondencias
Ejemplo: alineando dos imágenes
matching = se establecen correspondencias
- Brute-Force Matcher (BFMatcher en OpenCV).
- Fast Library for Approximate Nearest Neighbors (FlannBasedMatcher en OpenCV).
Ejemplo: alineando dos imágenes
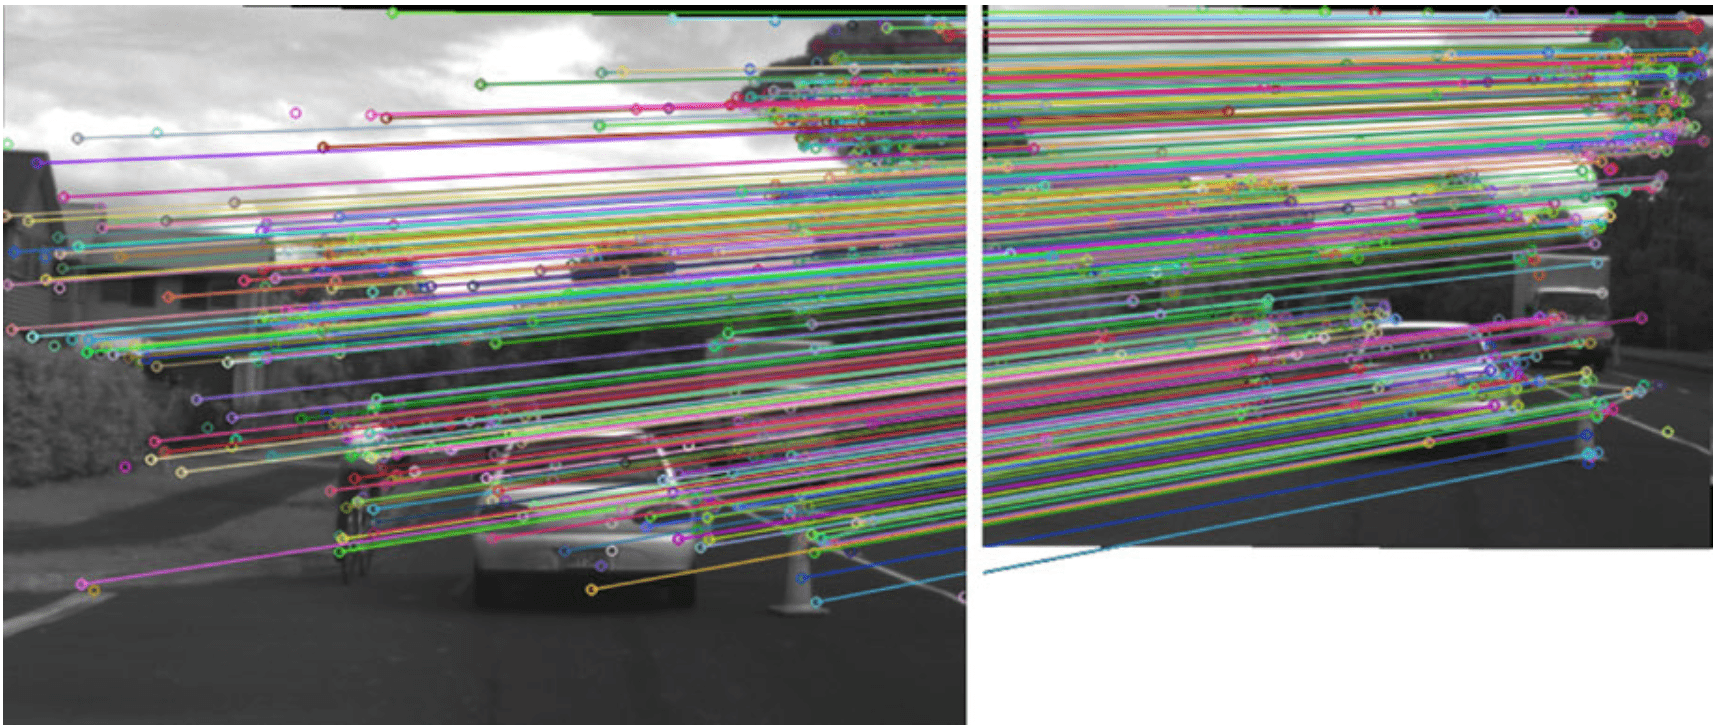
>> mt3006_clase3_feature_matching.m
Ejemplo: alineando dos imágenes
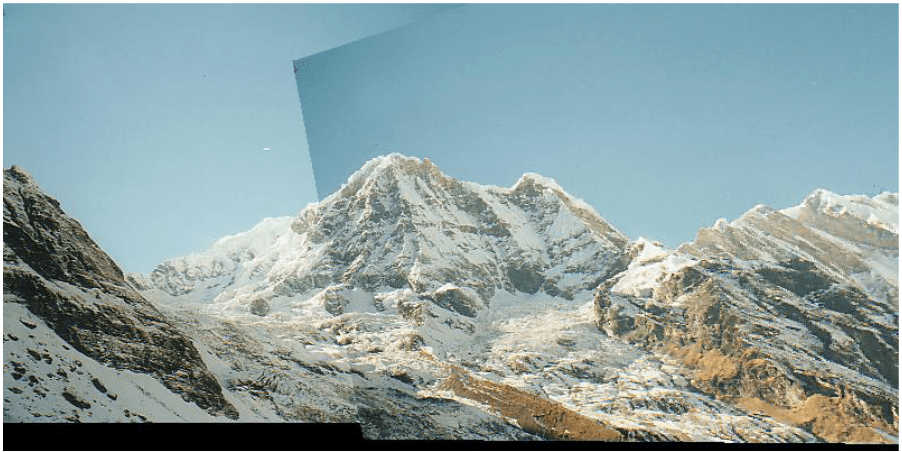
correspondencias \(\to\) información requerida \(\sim\) aplicación
Ejemplo: alineando dos imágenes
correspondencias \(\to\) información requerida \(\sim\) aplicación
- Estimación de movimiento.
- Reconocimiento de objetos y lugares.
- Registro de imágenes.
- Reconstrucción 3D.
- Formación de imágenes panorámicas.
- Indexado de imágenes.
- Estéreo visión.
>> mt3006_clase3_pose_dos_vistas.m
>> mt3006_clase3_secuencia_pose.m
Referencias
- D. Scaramuzza, Vision Algorithms for Mobile Robotics, UZH: Fall 2023. https://rpg.ifi.uzh.ch/teaching.html#VAMR