Joint inference of mass-maps and cosmology with diffusion models
Benjamin Remy
Open Skai Conference
Skai Institute, Chicago, September 2026
with Chihway Chang and Rebecca Willett
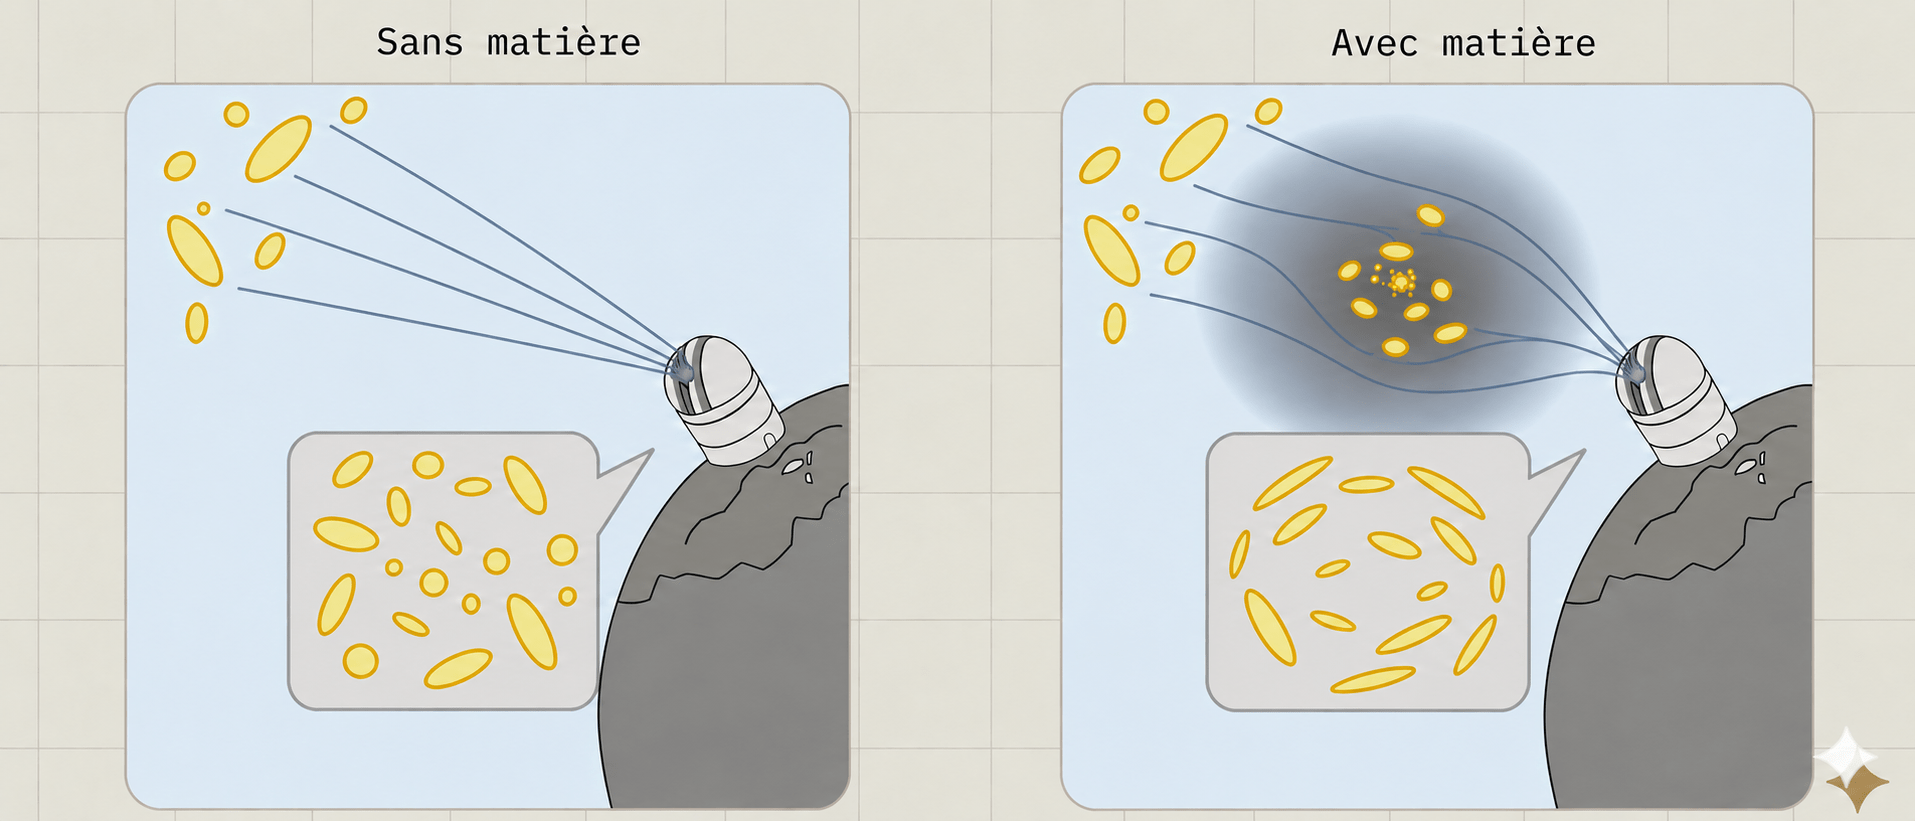
Weak lensing for cosmology
Credit: Jessie Muir adapted by Justine Zeghal
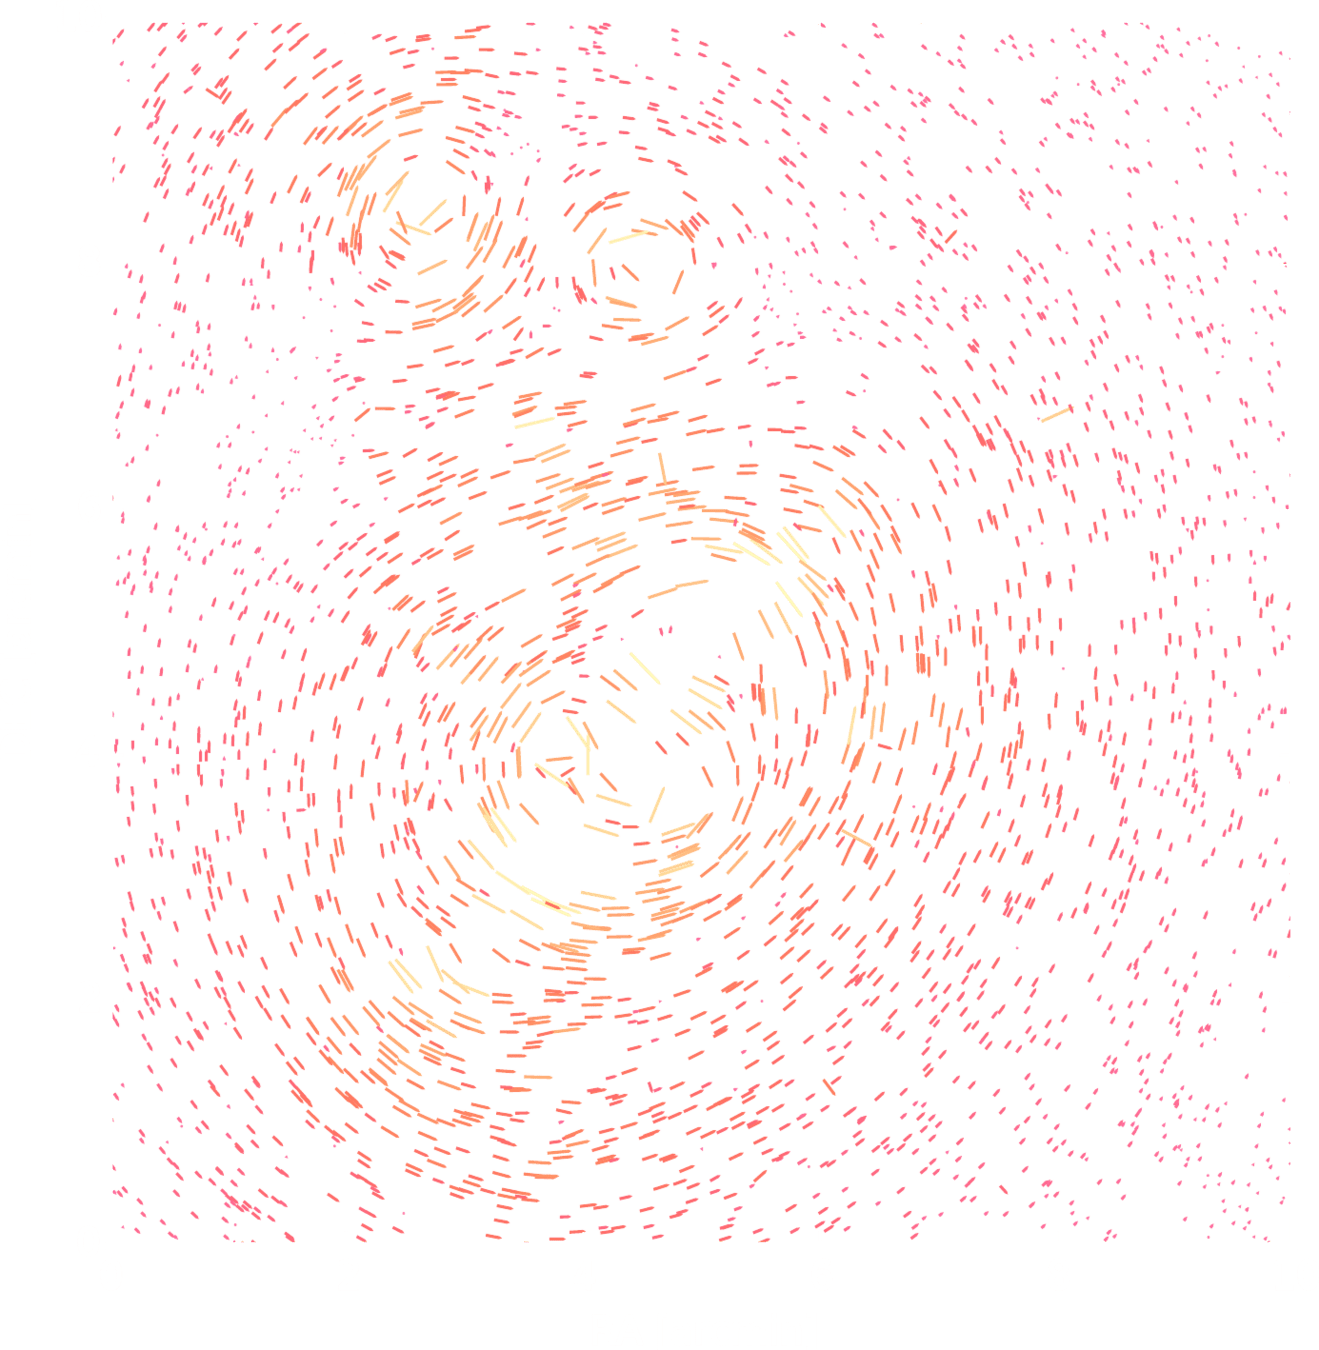
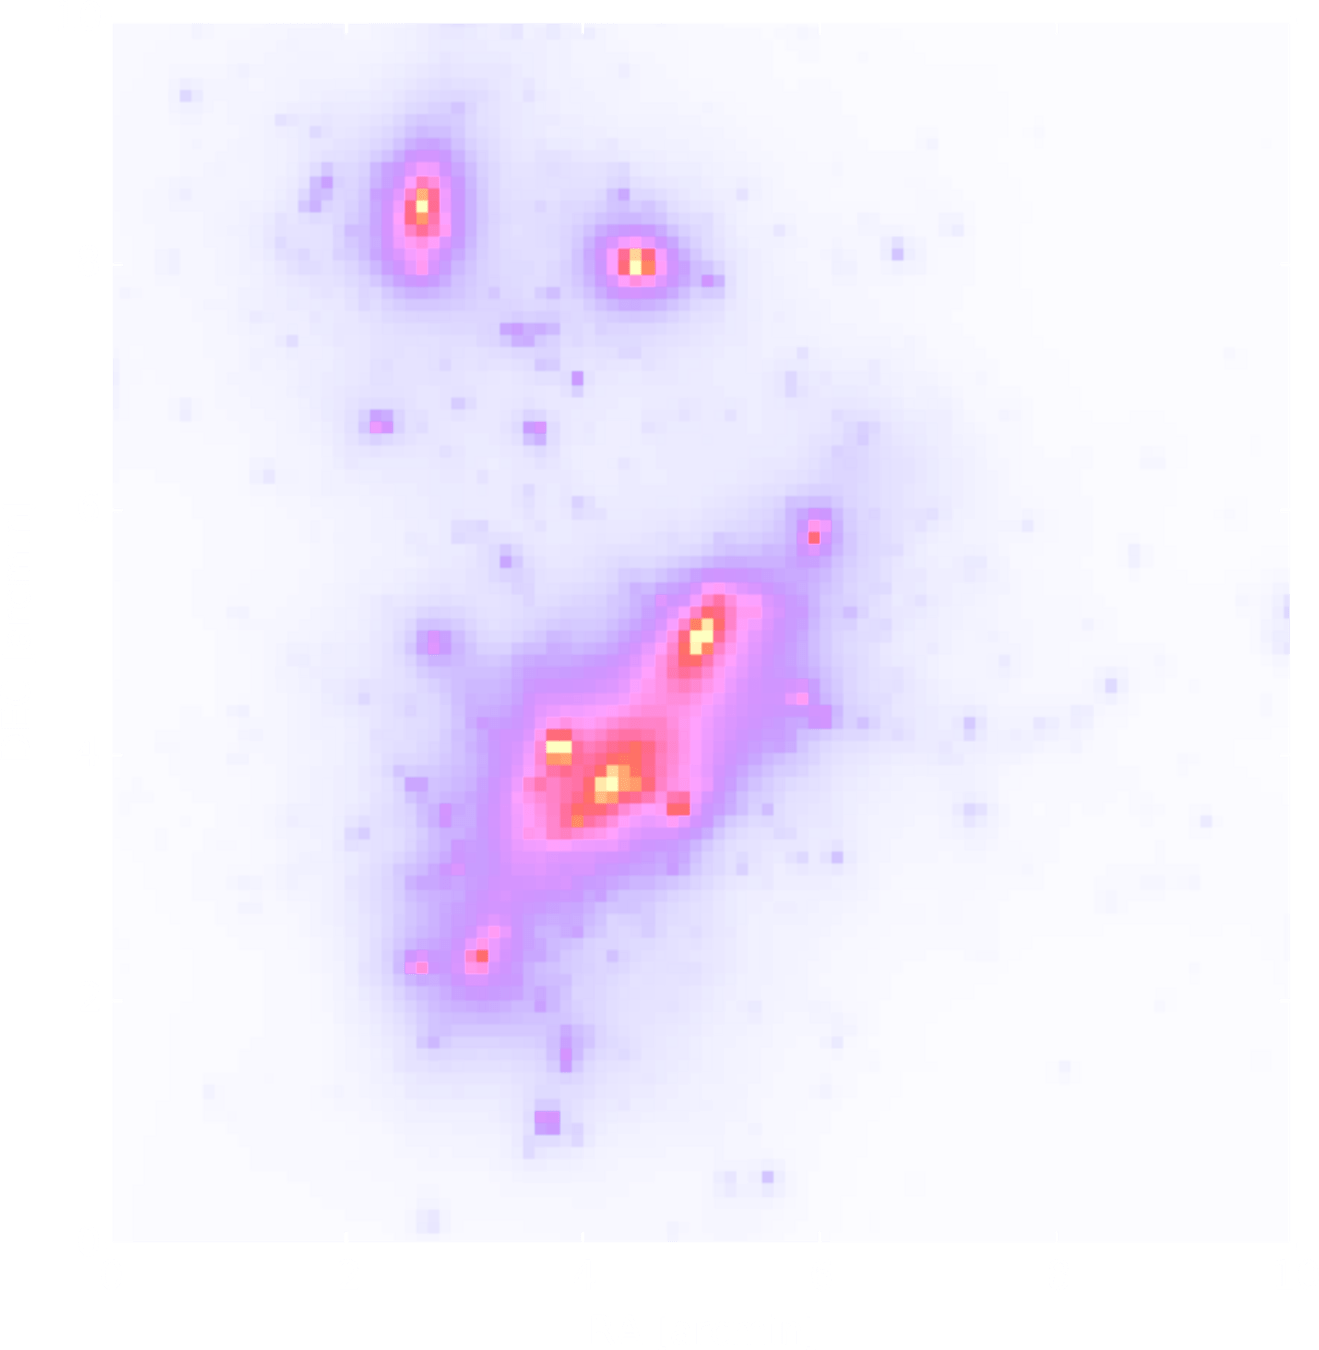
Shear
Convergence
How to optimally infer cosmology from observing ?
How to reconstruct with a non-linear model?
Weak lensing mass-mapping as an inverse problem
N-body +
ray-tracing
(e.g. TNG, Gower Street)
Forward model
Inference (inverse problem)
Running N-body simulations, we
implicitly sample from the joint distribution
Implicit inference uses
simulations to learn
the implicit distributions
(posterior, likelihood, likelihood ratio)
Full field inference
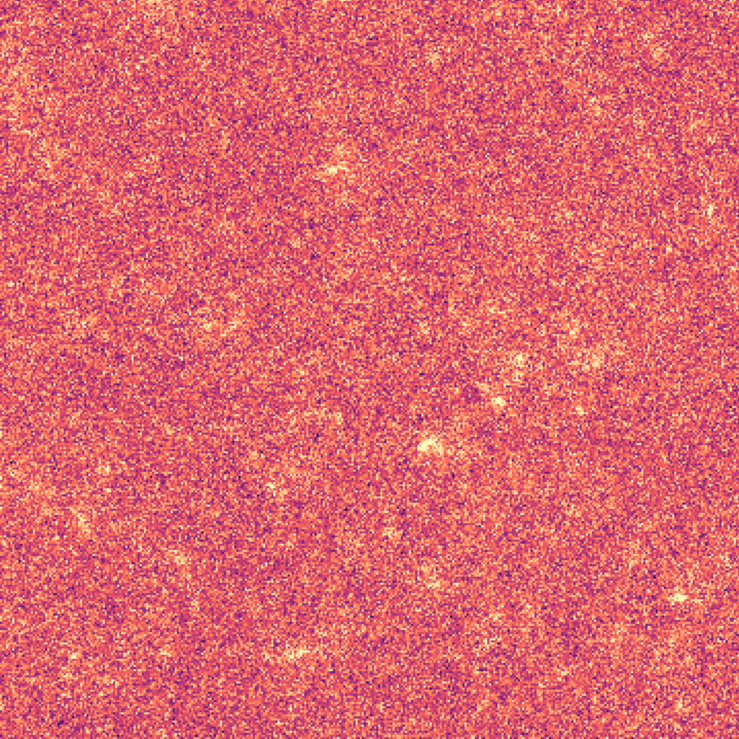
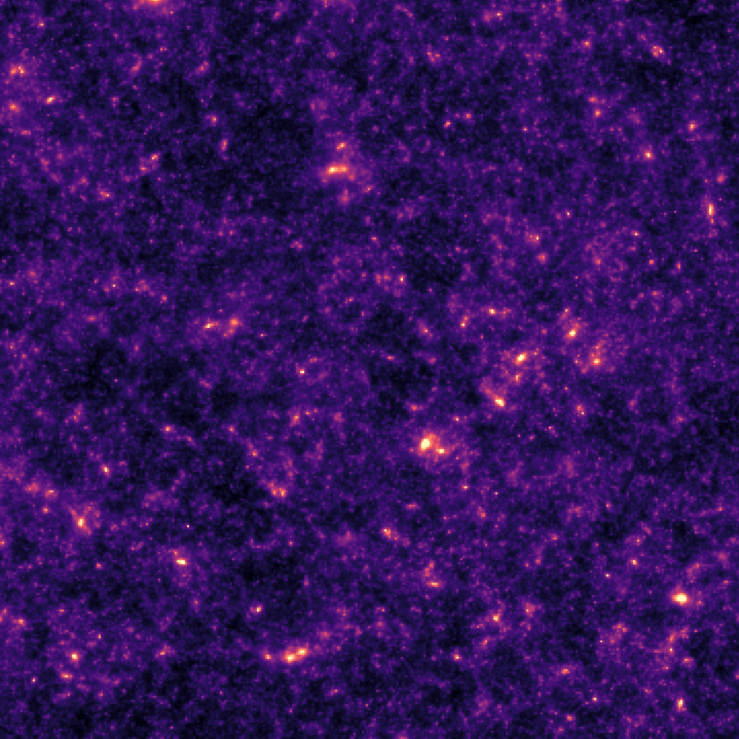
Full field inference x Implicit inference (LFI)
Field reconstruction
Cosmological inference
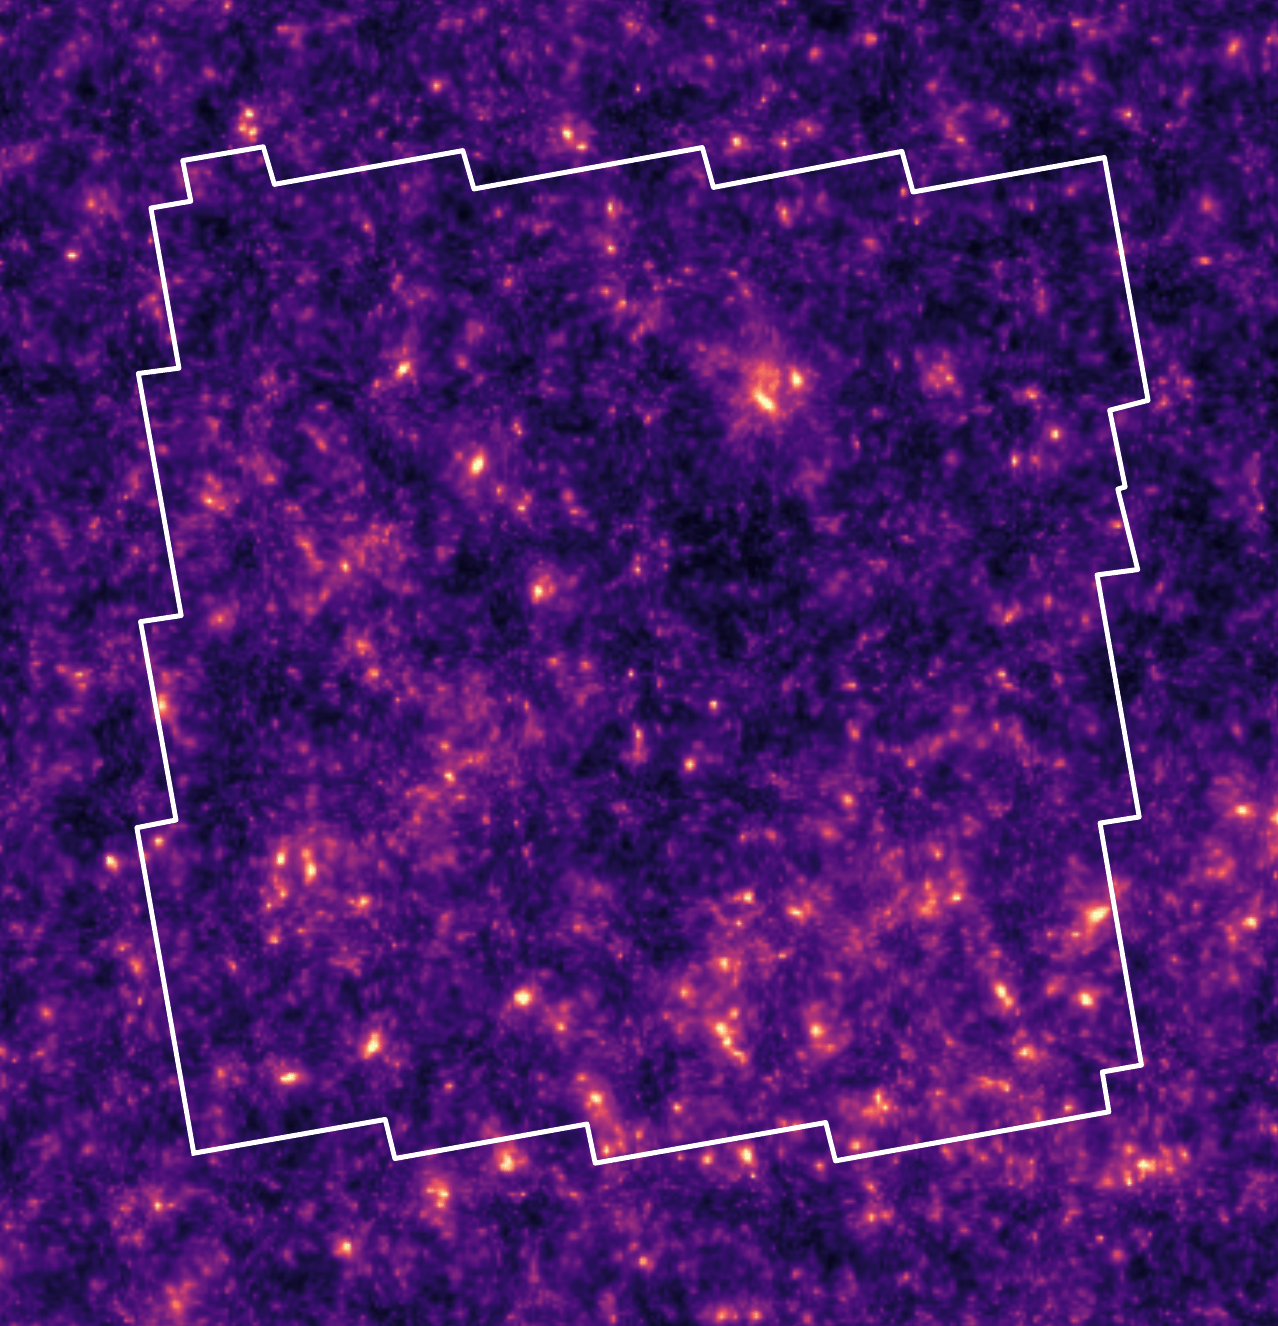
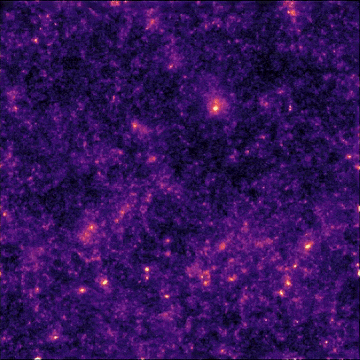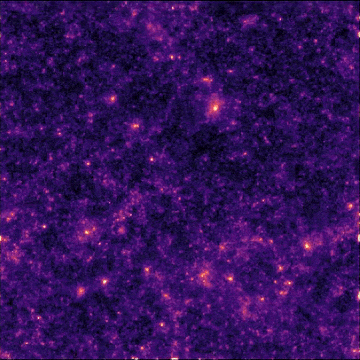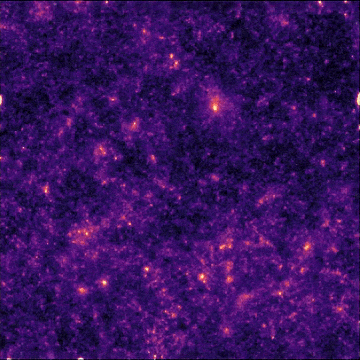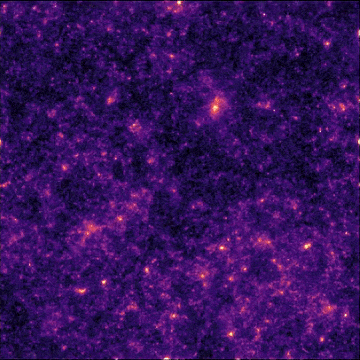
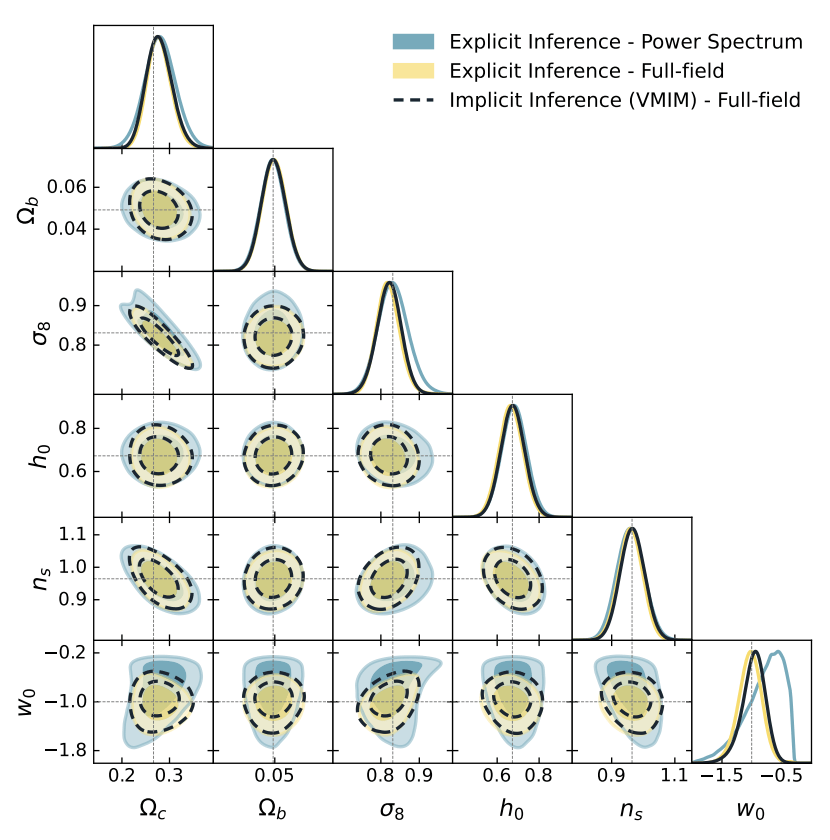
Targets
Targets
Posterior sampling with diffusion models (Remy et al. 2023)
Implicit inference for weak lensing full field
Implicit inference for weak lensing full field
How can we combine them in a joint inference framework ?
Text
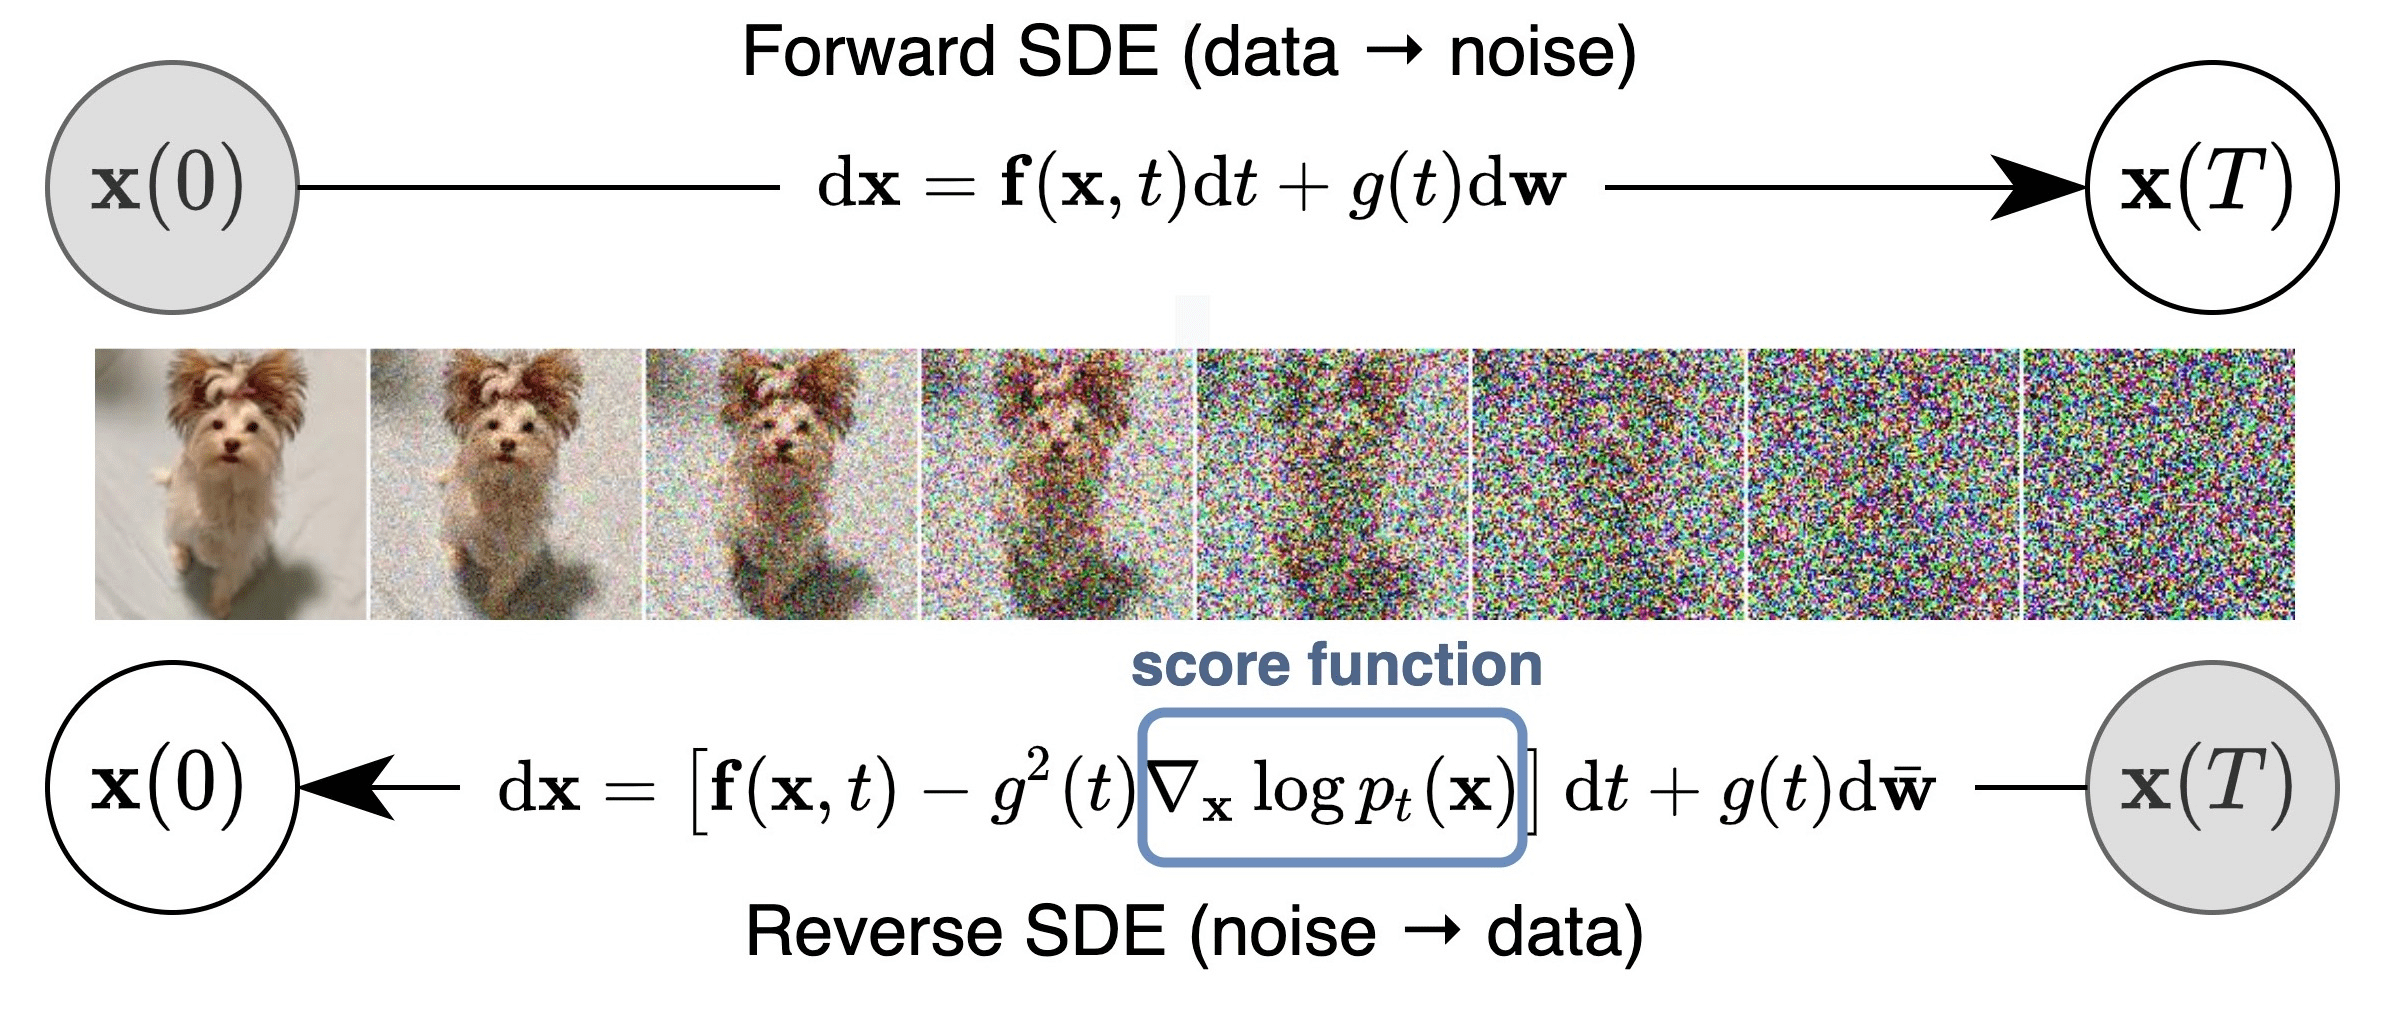
A diffusion model learns to reverse the noising process, by learning
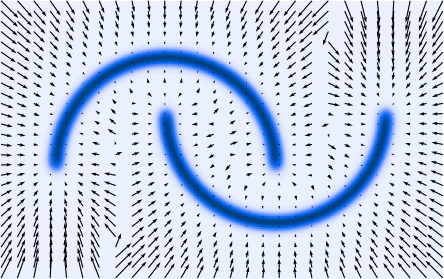
the prior score function
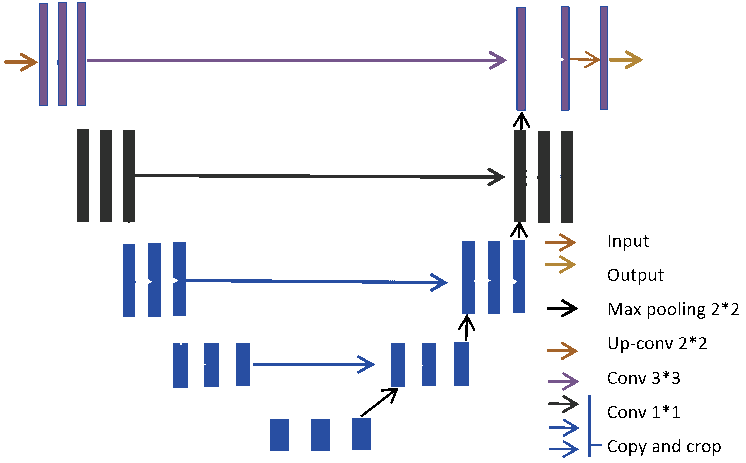
U-net architecture, well suited for 2D, 3D fields
But not for inferring cosmological parameters...
Tweedy formula
Posterior inference with diffusion model
A diffusion model learns to reverse the noising process, by learning
the posterior score function
U-net architecture, well suited for 2D, 3D fields
But not for inferring cosmological parameters...
Tweedy formula
Posterior inference with diffusion model
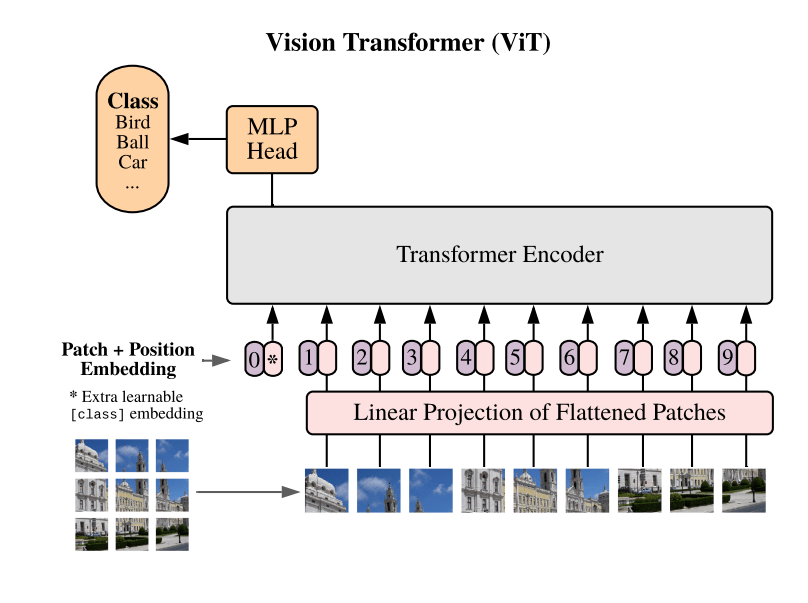
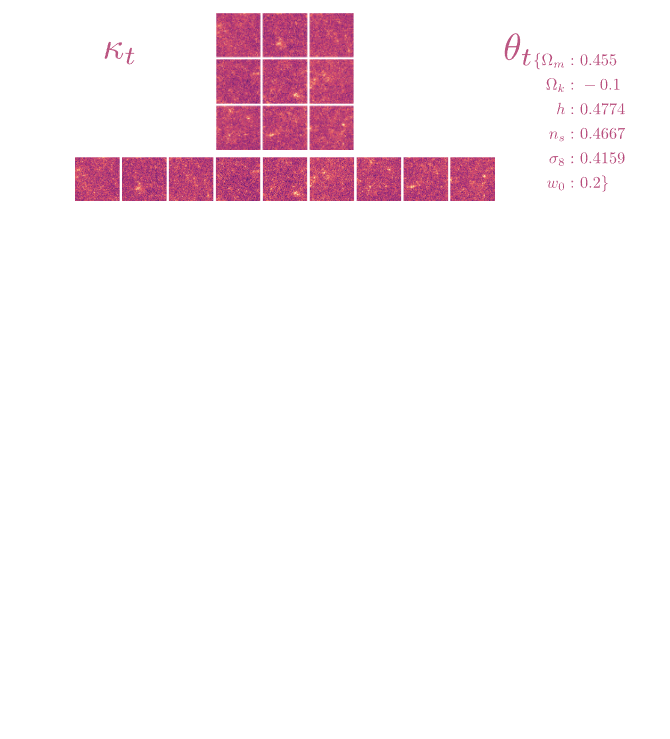
We need to model to design a denoiser architecture
to learn the score function.
We learn the joint denoiser
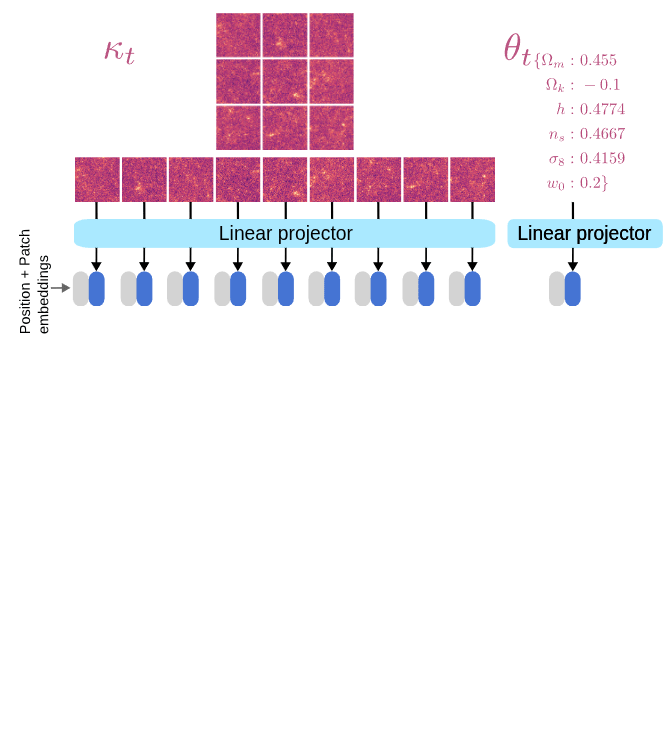
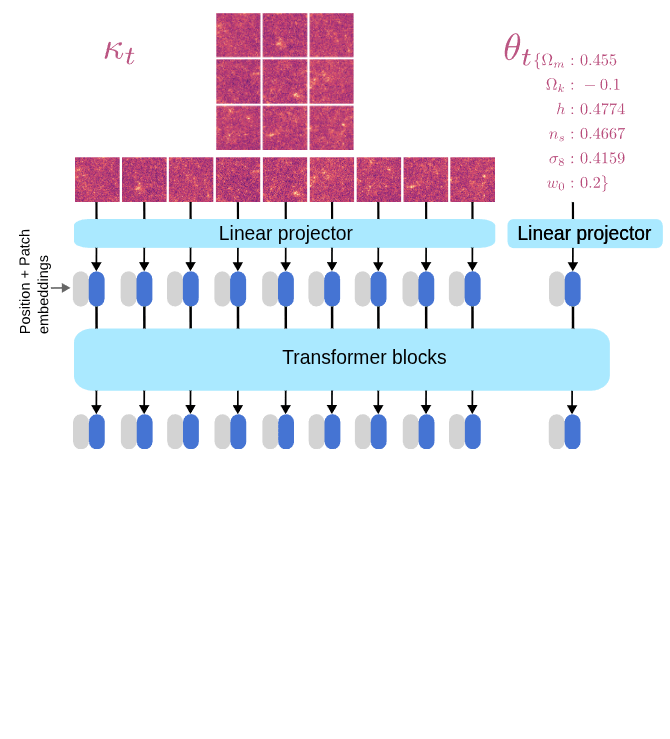
Learning the joint distribution
And now have the joint score function to run a diffusion model
Learning the joint distribution
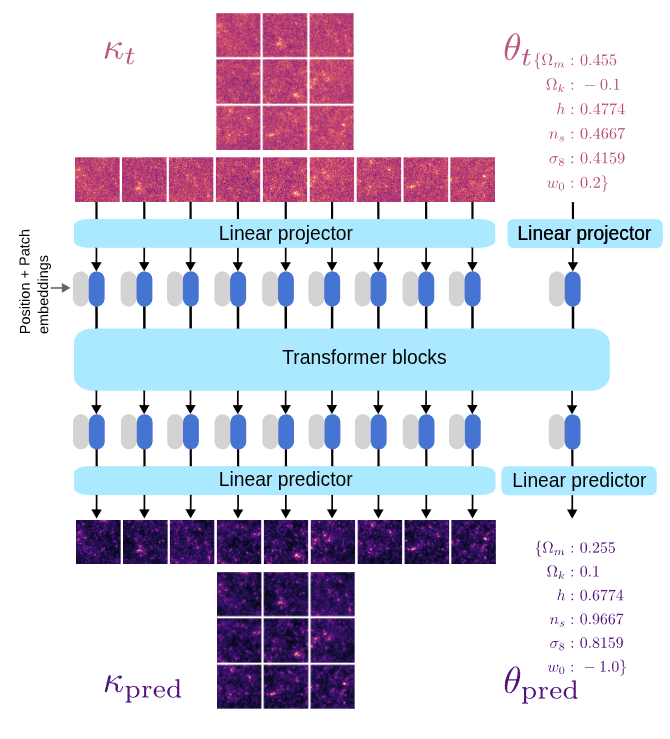
We need to model to design a denoiser architecture
to learn the score function.
We learn the joint denoiser
And now have the joint score function to run a diffusion model
Learning the joint distribution
We need to model to design a denoiser architecture
to learn the score function.
We learn the joint denoiser
And now have the joint score function to run a diffusion model
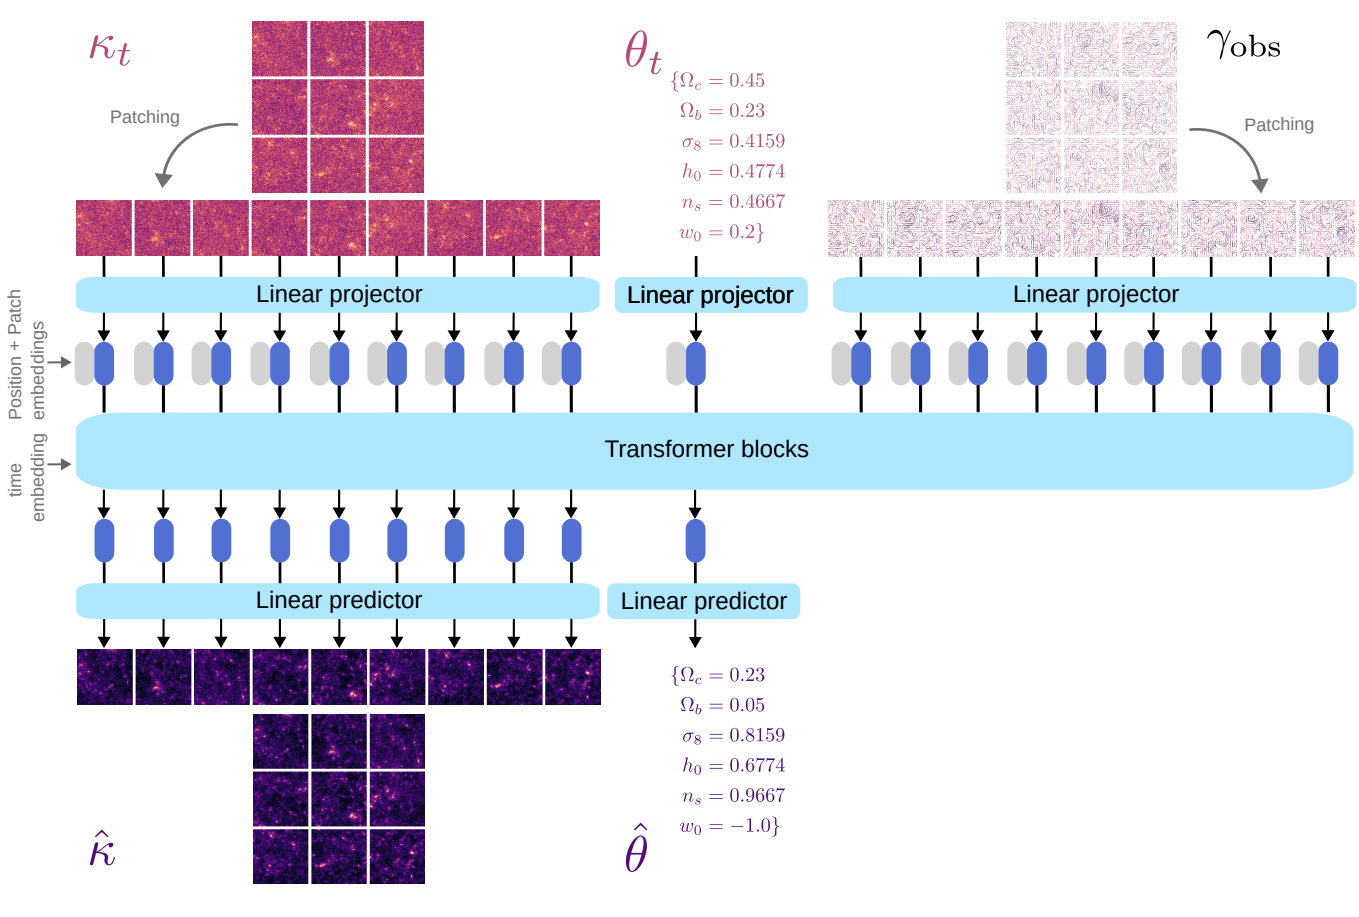
Learning the joint distribution
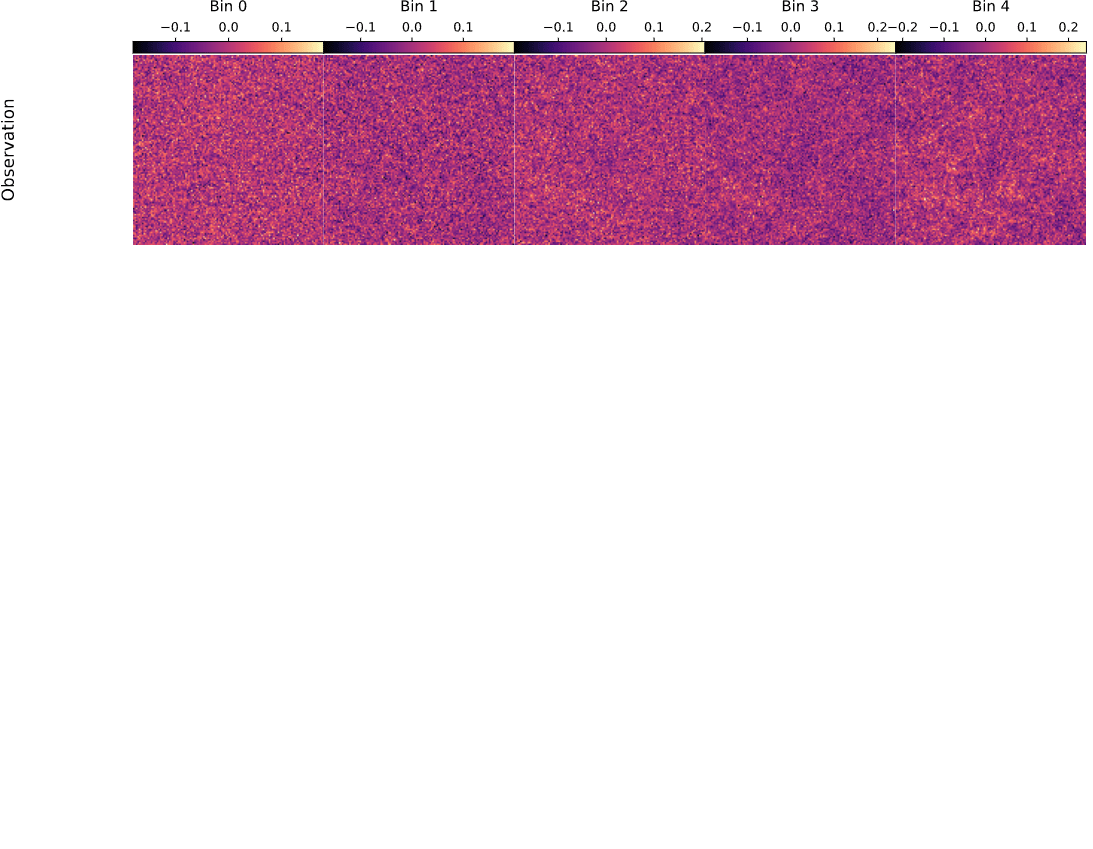
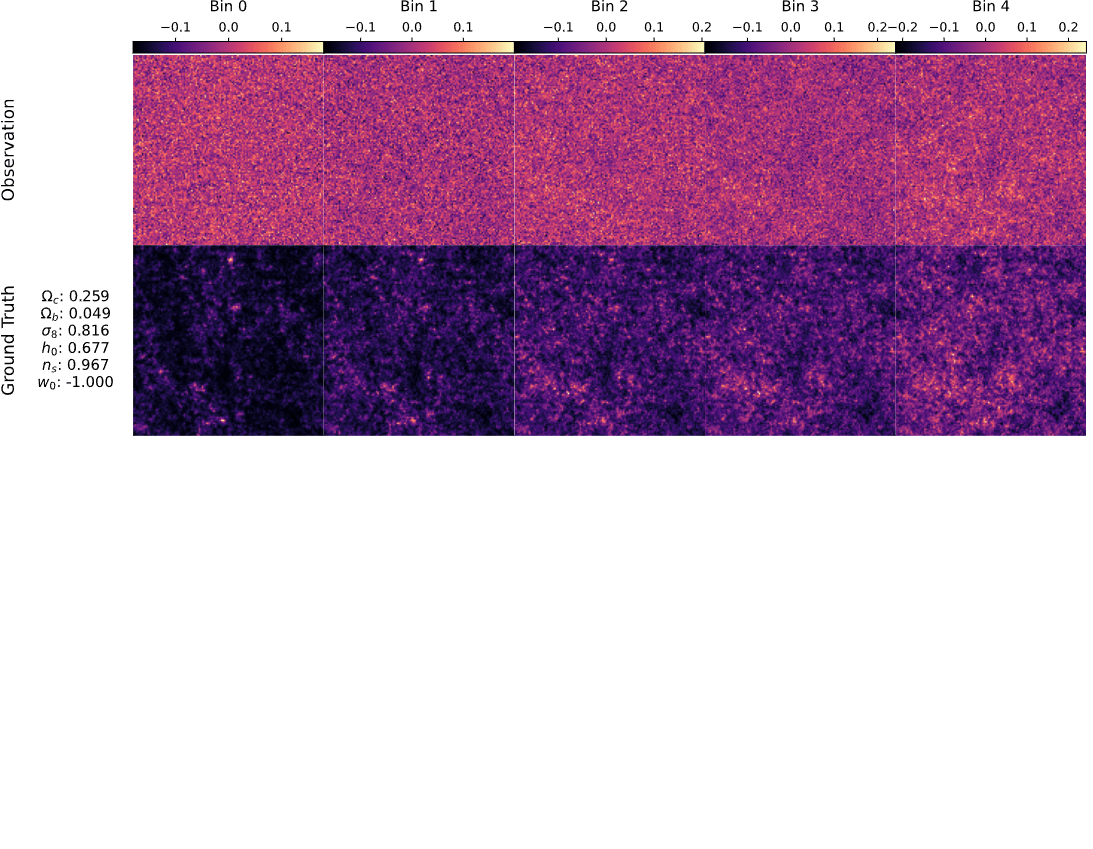
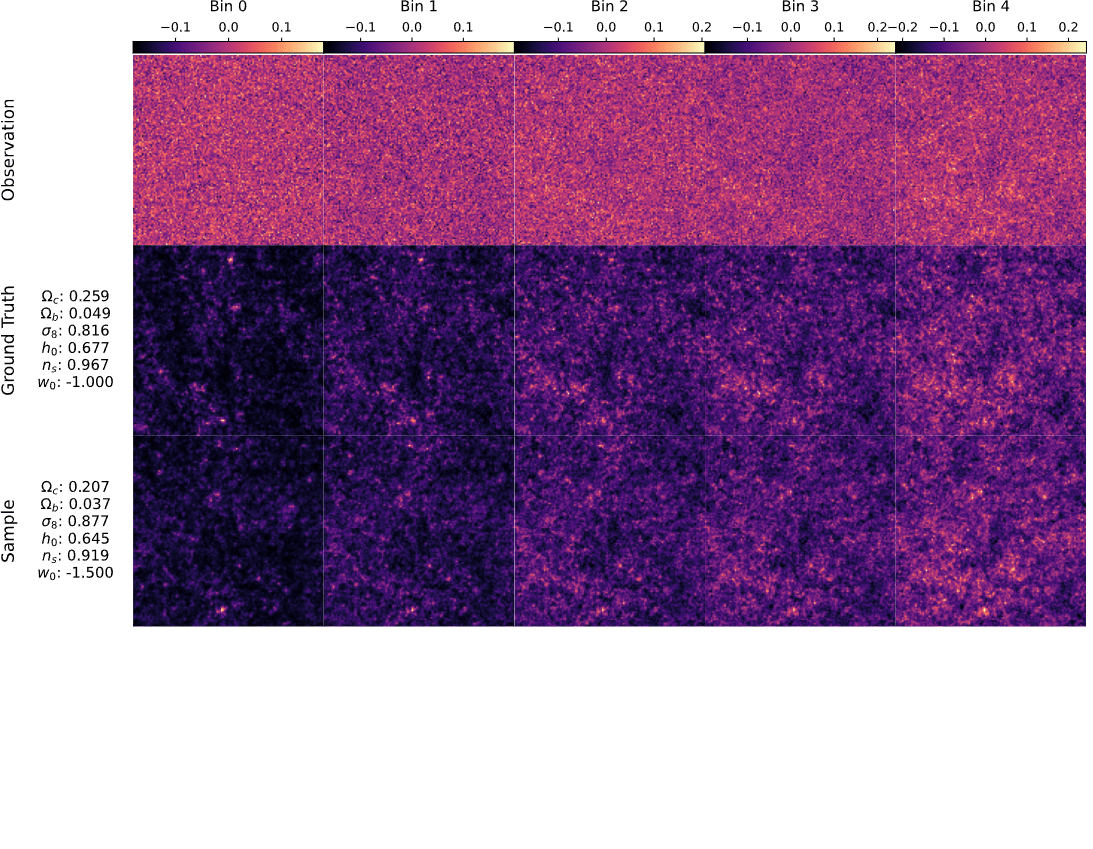
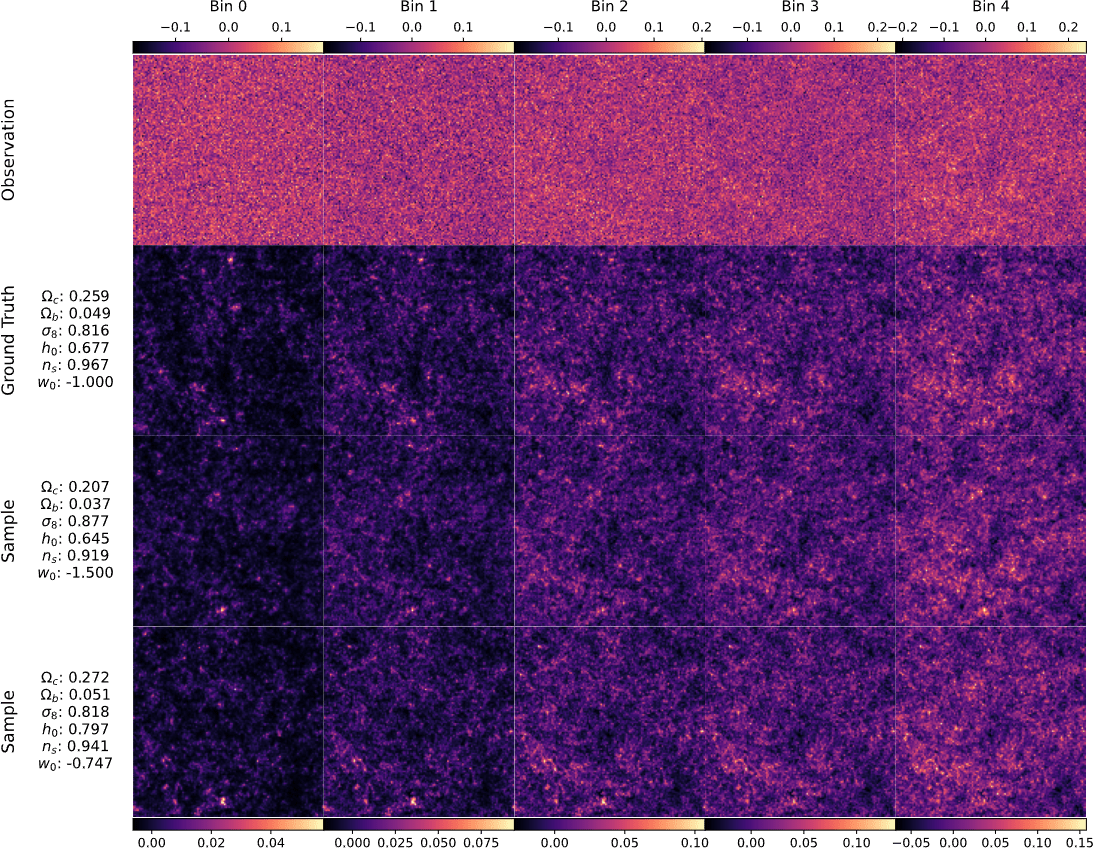
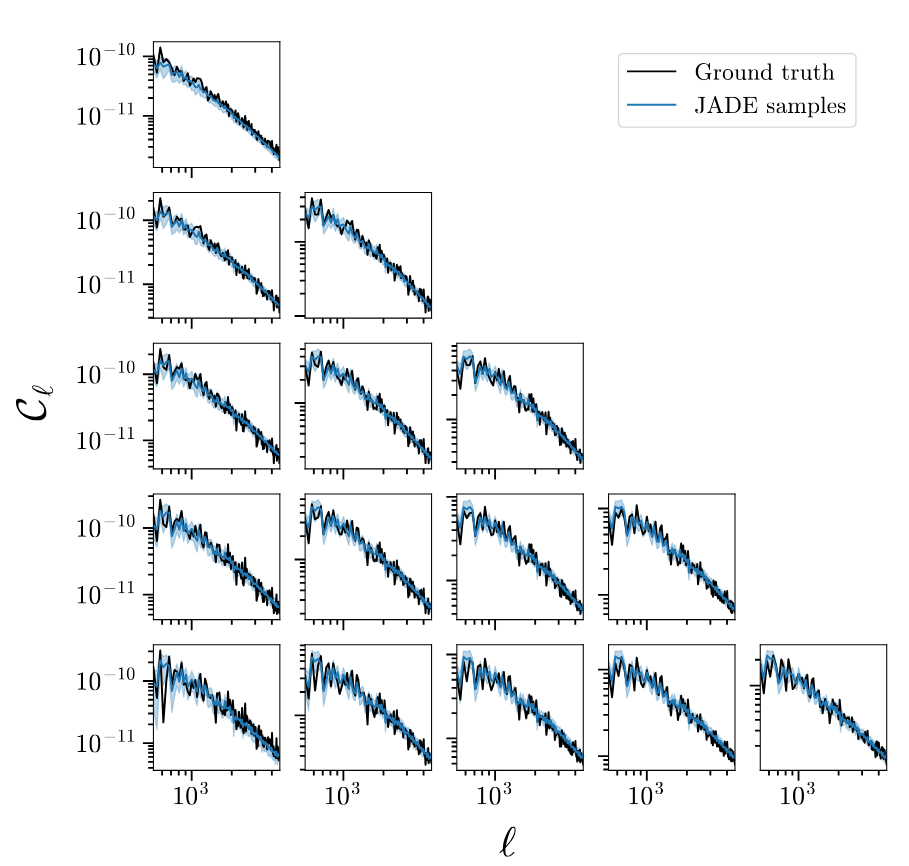
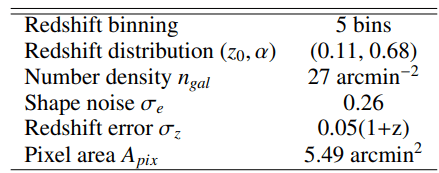
Mocked weak lensing maps
with sbi_lens
128x128x5 maps, spanning
10x10 deg²
LSST Y10-like survey setting
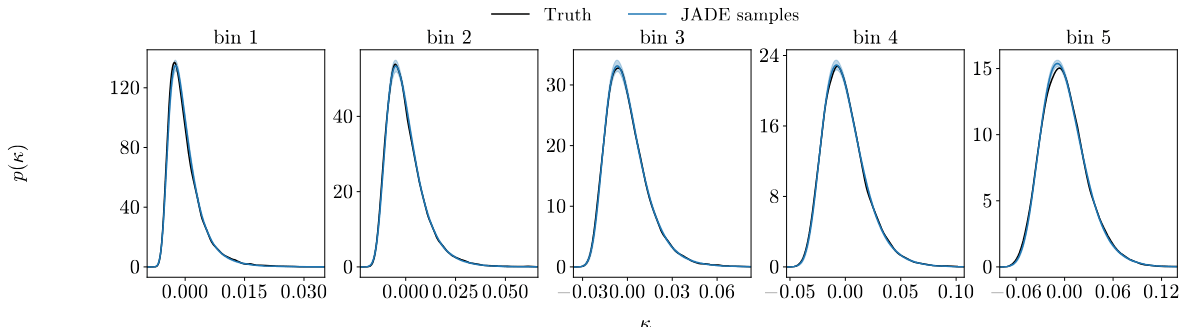
Results
Learning the joint distribution
Results
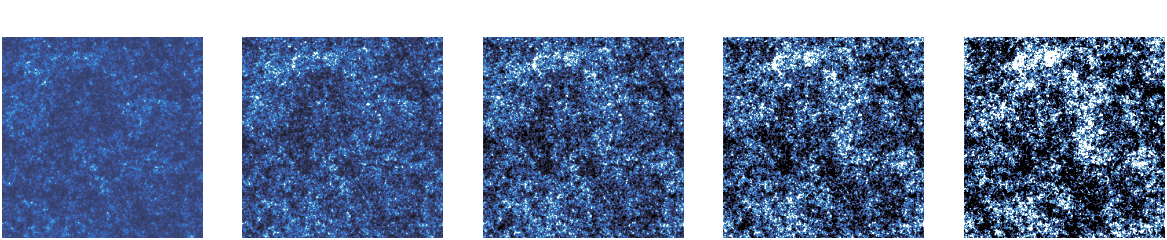
A fast and differentiable (JAX) log-normal mass maps simulator
sbi-lens
Learning the joint distribution
Results
Learning the joint distribution
Results
Learning the joint distribution
Results
Learning the joint distribution
Results
Learning the joint distribution
Results
Learning the joint distribution
Results
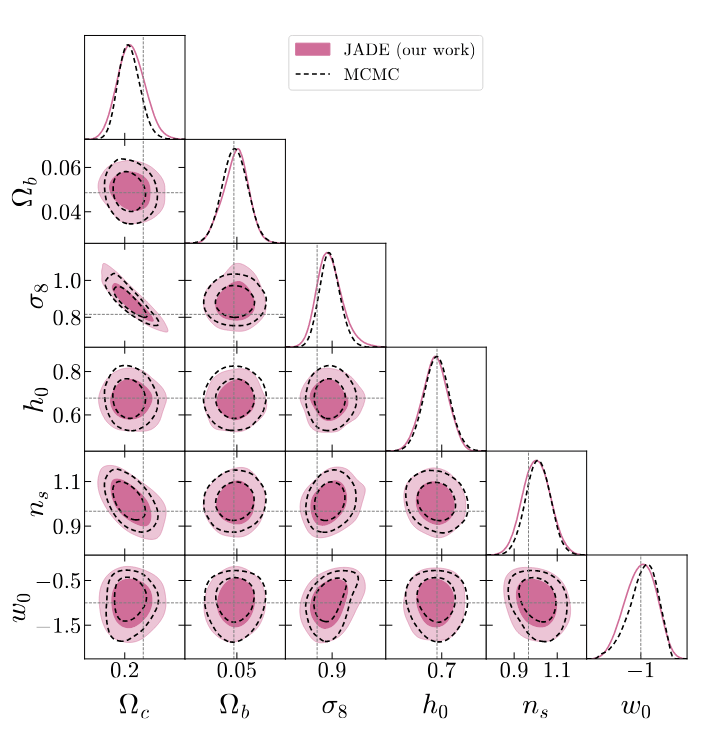
Cosmology marginal
TARP coverage test (Lemos et al. 2023)
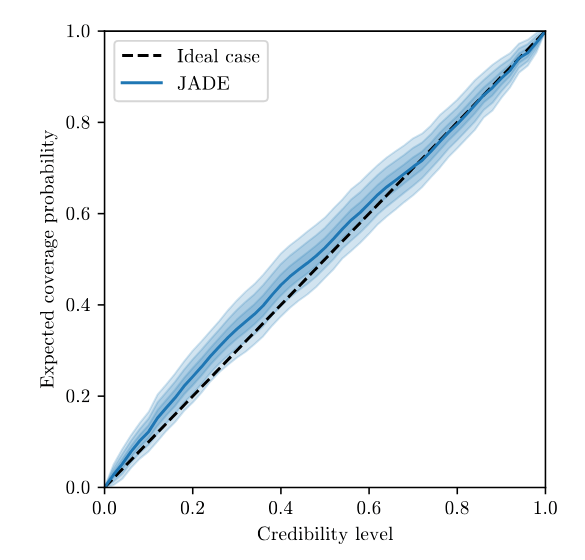
MIRA calibration score (Sharief, Zeghal, et al. 2026)
on the joint distribution, where 2/3 is optimal
Results
Explicit conditioning
Joint prior
Linear model
Gaussian likelihood
and include
- lensing operator
- survey mask
- survey noise
Explicit conditioning
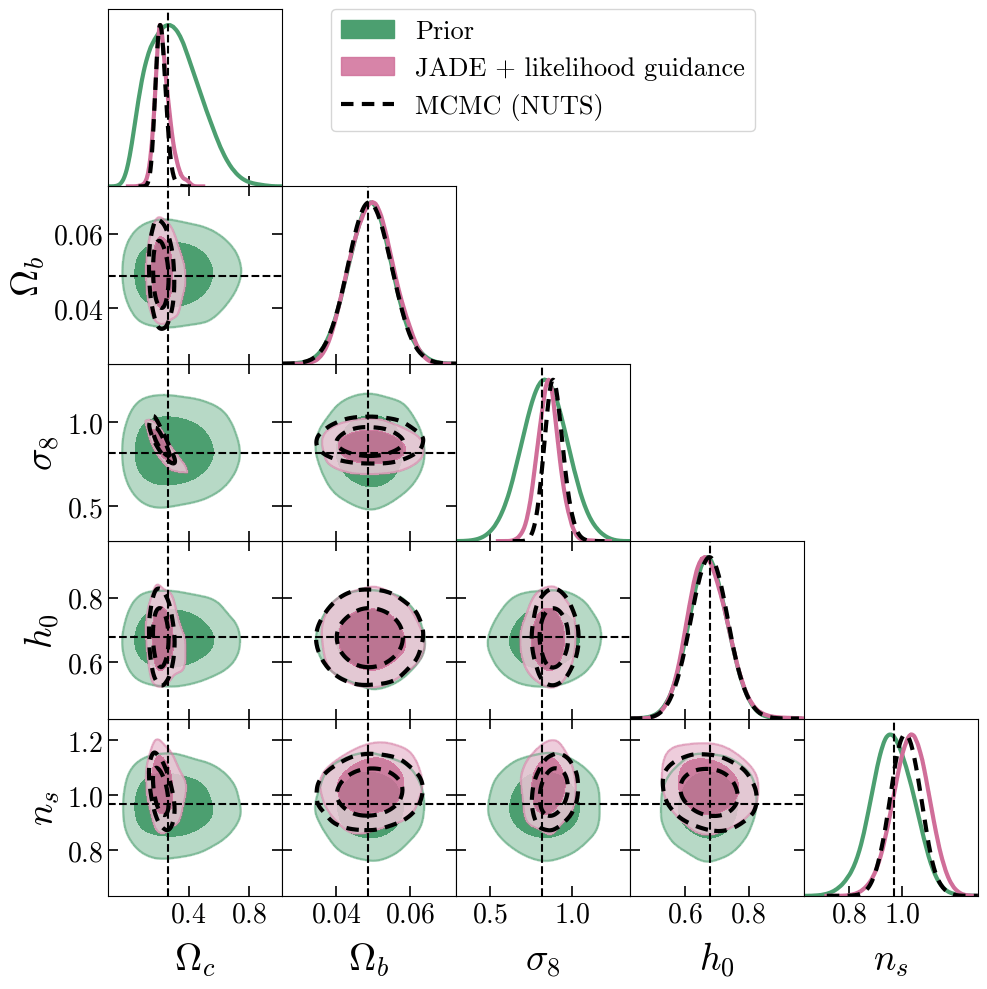
Joint prior
Linear model
Gaussian likelihood
Explicit conditioning
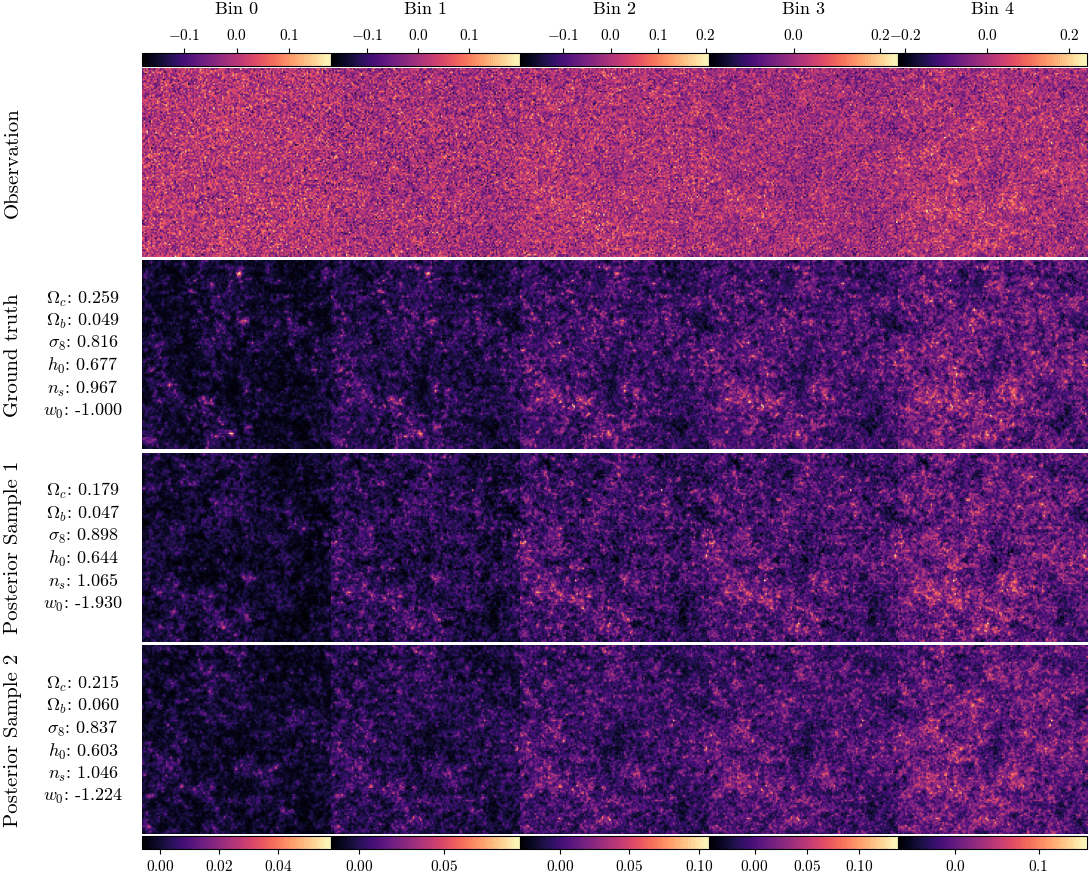
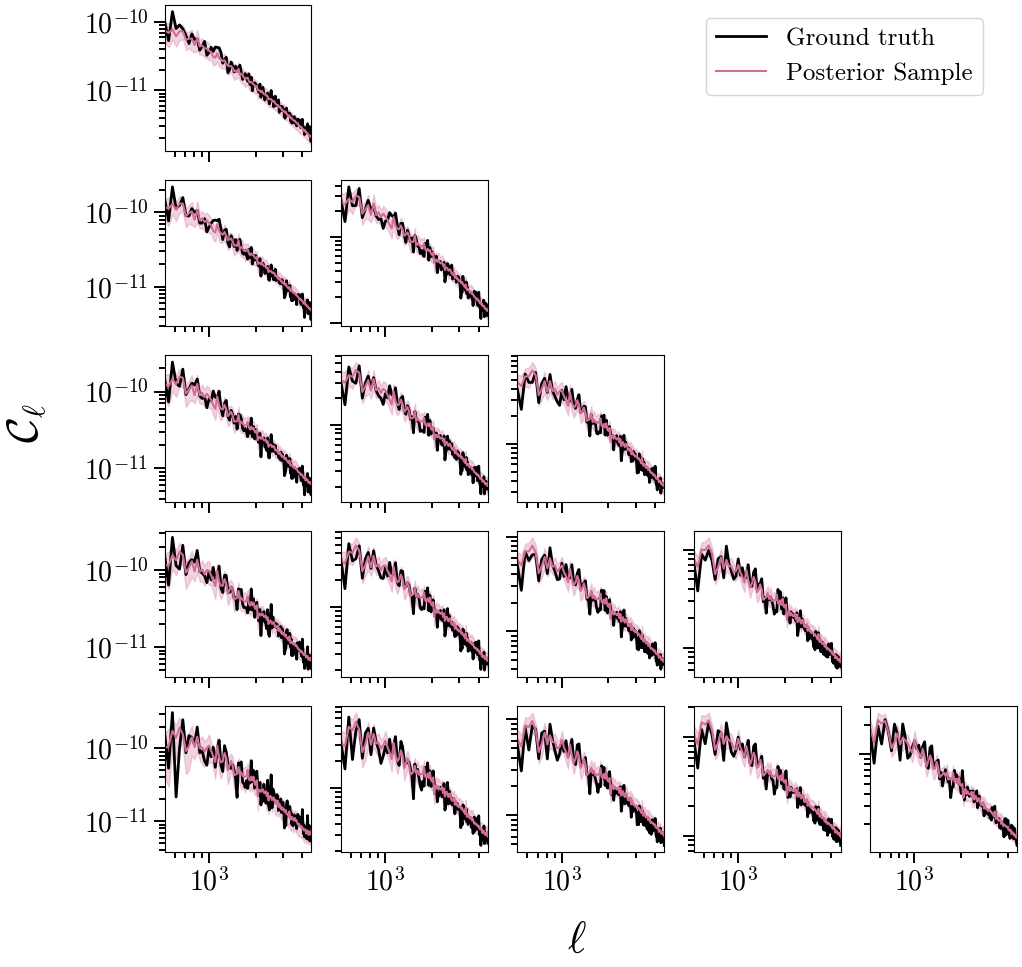
We built a generative model of mass-maps and cosmology, that we can condition on observation to get the joint posterior distribution
Thank you!
This approach could be extended for inference, or to build efficient proposal, of initial condition and cosmology
Happy to chat about this!
Takeaways